Código
library(tidyverse)

dados <- read_delim(
  "base_processamento_dados_engenharia_civil.csv",
  delim = ";",
  locale = locale(decimal_mark = "."),
  show_col_types = FALSE
)
Estatística e Probabilidade
Prof. Ben Dêivide (DEFIM/CAP/UFSJ)
A análise de dados é uma ferramenta de grande valor para o acompanhamento e o controle de qualidade dos materiais empregados nas obras, no âmbito da Engenharia Civil. No controle tecnológico do concreto, informações como resistência à compressão, abatimento, relação água/cimento e idade dos corpos de prova auxiliam na avaliação do desempenho do material e na identificação de possíveis resultados fora do comportamento esperado.
Entretanto, dados obtidos em ensaios, registros de campo e planilhas podem apresentar valores ausentes, erros de digitação e inconsistências de preenchimento. Por esse motivo, antes da realização das análises estatísticas, é importante verificar a qualidade dos registros e realizar os tratamentos necessários para garantir maior confiabilidade aos resultados.
Nesse contexto, este relatório utilizará a linguagem R para inspecionar, tratar e explorar uma base de dados relacionada ao controle tecnológico do concreto, buscando transformar os dados brutos em informações úteis para sua análise e interpretação.
Processar e analisar uma base de dados referente ao controle tecnológico do concreto, utilizando prioritariamente as ferramentas da família tidyverse, dentro da linguagem R, para identificar e tratar inconsistências e obter informações relevantes para a interpretação dos resultados.
tidyverse, dentro da linguagem R para manipulação e exploração dos dados;O desenvolvimento deste trabalho será realizado a partir de uma base de dados relacionada ao controle tecnológico do concreto, contendo informações referentes aos corpos de prova, à sua localização na obra, ao tipo de concreto, à idade de ensaio e às características do material. O processamento e a análise dos dados serão realizados utilizando a linguagem R, priorizando as ferramentas da família tidyverse e o operador |> para a construção dos fluxos de processamento.
Inicialmente, será realizada a importação e a inspeção da base de dados, buscando compreender sua estrutura, identificar as variáveis presentes e verificar como foram reconhecidas pelo R. Nessa etapa, também serão analisadas as dimensões da base e os tipos das variáveis, permitindo identificar possíveis problemas que possam interferir nas etapas seguintes.
Em seguida, será realizada a investigação da qualidade dos dados, considerando a existência de valores ausentes, erros de digitação e formatação, inconsistências na padronização das categorias e valores que apresentem comportamento diferente do restante da base. Para essa investigação, serão utilizadas ferramentas dos pacotes dplyr, tidyr, stringr e readr. Quando necessário, serão realizadas correções, conversões e padronizações, mantendo-se uma cópia da base original.
Após o tratamento, será realizada a exploração dos dados por meio de estatísticas descritivas e agrupamentos, considerando a resistência à compressão e sua relação com o tipo de concreto, o bloco da obra e a idade dos corpos de prova. Também serão analisadas outras características do material, como consumo de cimento, relação água/cimento, abatimento, densidade e absorção do agregado. Para essas análises, serão utilizadas principalmente as funções de manipulação e transformação disponíveis no pacote dplyr.
Além disso, serão criadas variáveis derivadas a partir das informações existentes, permitindo comparar a resistência observada com a resistência de referência de cada classe de concreto, classificar os resultados e identificar valores superiores à média de cada classe. Serão realizadas, também, transformações simultâneas em diferentes variáveis por meio da função across(), buscando explorar as possibilidades de processamento oferecidas pelas ferramentas do tidyverse.
Por fim, os dados tratados serão utilizados na análise de situações relacionadas à prática profissional da Engenharia Civil. Serão realizadas comparações entre os blocos da obra e as classes de concreto, além da análise do comportamento da resistência em função da idade, do consumo de cimento e da relação água/cimento. As análises serão complementadas por representações gráficas elaboradas com o pacote ggplot2 e por tabelas organizadas com knitr::kable(), buscando facilitar a interpretação dos resultados obtidos no controle tecnológico do concreto.
Principais funções e comandos utilizados no R
read_delim() e parse_double() - importação e conversão dos dados;glimpse() e summary() - inspeção da estrutura e resumo da base;summarise(), n() e across() - obtenção de estatísticas e aplicação de operações a diferentes variáveis;is.na(), if_any() e drop_na() - identificação, localização e tratamento dos valores ausentes;select(), filter(), slice_head() e slice_tail() - seleção de variáveis e observações;pivot_longer() - reorganização da estrutura dos dados;mutate() e transmute() - criação e transformação de variáveis;str_replace(), str_replace_all(), str_trim(), str_to_upper(), str_to_title() e str_detect() - correção, padronização e investigação de textos;count(), distinct() e arrange() - contagem, identificação e organização dos registros;group_by() e ungroup() - agrupamento e desagrupamento das observações;case_when() e if_else() - aplicação de condições para correção, classificação e criação de variáveis;mean(), median(), sd(), min() e max() - cálculo das medidas estatísticas;ggplot(), geom_boxplot(), geom_point(), geom_line(), geom_col() e geom_smooth() - elaboração das representações gráficas;knitr::kable() - organização e apresentação das tabelas no relatório;|> - construção dos fluxos de processamento e transformação dos dados.A base de dados foi importada para o R através da função read_delim()e atribuída a dados.
library(tidyverse)
dados <- read_delim(
"base_processamento_dados_engenharia_civil.csv",
delim = ";",
locale = locale(decimal_mark = "."),
show_col_types = FALSE
)Para verificar a correta importação dos dados, foram visualizadas as seis primeiras e as seis últimas observações da base utilizando, respectivamente, as funções slice_head() e slice_tail().
dados |>
  slice_head(n = 6) |>
  knitr::kable(
    caption = "Primeiras observações da base de dados",
    digits = 2
)| id_corpo_prova | obra | tipo_concreto | idade_dias | resistencia_mpa | cimento_kg_m3 | relacao_a_c | abatimento_mm | densidade_kg_m3 | absorção_agregado_pct |
|---|---|---|---|---|---|---|---|---|---|
| CP-001 | Bloco A | C35 | 28 | 36.3 | 395 | 0.5 | 111 | 2332 | 2.30 |
| CP-002 | Bloco A | C30 | 7 | 28.4 | 340 | 0.54 | 114 | 2389 | 1.85 |
| CP-003 | Bloco C | C30 | 56 | 36.1 | 338 | 0.56 | 106 | 2427 | 1.89 |
| CP-004 | Bloco A | C40 | 28 | 47.2 | 407 | 0.47 | 142 | 2345 | 1.97 |
| CP-005 | Bloco B | C25 | 28 | 27.9 | 316 | 0.61 | 133 | 2448 | 2.31 |
| CP-006 | Bloco B | C40 | 28 | 41.5 | 398 | 0.43 | 98 | 2324 | 0.80 |
dados |>
  slice_tail(n = 6) |>
  knitr::kable(
    caption = "Últimas observações da base de dados",
    digits = 2
)| id_corpo_prova | obra | tipo_concreto | idade_dias | resistencia_mpa | cimento_kg_m3 | relacao_a_c | abatimento_mm | densidade_kg_m3 | absorção_agregado_pct |
|---|---|---|---|---|---|---|---|---|---|
| CP-095 | Bloco A | C25 | 28 | 30.3 | 327 | 0.63 | 124 | 2334 | 1.55 |
| CP-096 | Bloco D | C25 | 7 | 21.3 | 295 | 0.59 | 117 | 2349 | 1.72 |
| CP-097 | Bloco A | C25 | 28 | 26.7 | 356 | 0.64 | 122 | 2440 | NA |
| CP-098 | Bloco A | C35 | 14 | 37.0 | 375 | 0.46 | 137 | 2387 | 2.04 |
| CP-099 | Bloco C | C25 | 56 | 31.1 | 332 | 0.62 | 81 | 2414 | 1.88 |
| CP-100 | Bloco A | C30 | 56 | 30.9 | 377 | 0.55 | 109 | 2346 | 1.13 |
Para verificar as dimensões da base, utilizou-se summarise(), em conjunto com n() para contabilizar o número de observações e ncol() para obter a quantidade de variáveis.
dados |>
  summarise(
    observacoes = n(),
    variaveis = ncol(dados)
  ) |>
  knitr::kable(
    caption = "Dimensões da base de dados"
)| observacoes | variaveis |
|---|---|
| 100 | 10 |
Portanto, a base de dados é composta por 100 observações e 10 variáveis.
dados |>
  glimpse()
Rows: 100
Columns: 10
$ id_corpo_prova <chr> "CP-001", "CP-002", "CP-003", "CP-004", "CP-005"…
$ obra <chr> "Bloco A", "Bloco A", "Bloco C", "Bloco A", "Blo…
$ tipo_concreto <chr> "C35", "C30", "C30", "C40", "C25", "C40", "C25",…
$ idade_dias <dbl> 28, 7, 56, 28, 28, 28, 56, 28, 14, 7, 7, 28, 28,…
$ resistencia_mpa <chr> "36.3", "28.4", "36.1", "47.2", "27.9", "41.5", …
$ cimento_kg_m3 <chr> "395", "340", "338", "407", "316", "398", "351",…
$ relacao_a_c <chr> "0.5", "0.54", "0.56", "0.47", "0.61", "0.43", "…
$ abatimento_mm <dbl> 111, 114, 106, 142, 133, 98, 99, 116, 125, 127, …
$ densidade_kg_m3 <dbl> 2332, 2389, 2427, 2345, 2448, 2324, 2385, 2387, …
$ absorção_agregado_pct <dbl> 2.30, 1.85, 1.89, 1.97, 2.31, 0.80, 1.18, 1.33, …A estrutura da base foi inspecionada por meio da função glimpse(). Com o resultado obtido, já é possível verificar como o R reconheceu as variáveis, mas para uma visualização mais clara, será utilizada a função class() aplicada às colunas da base por meio de across()
tipos_variaveis <- dados |>
  summarise(
    across(
      everything(),
      ~ class(.x)
    )
  ) |>
  pivot_longer(
    cols = everything(),
    names_to = "Variável",
    values_to = "Tipo reconhecido pelo R"
  )

tipos_variaveis |>
  knitr::kable(
    caption = "Tipos das variáveis reconhecidos pelo R"
)| Variável | Tipo reconhecido pelo R |
|---|---|
| id_corpo_prova | character |
| obra | character |
| tipo_concreto | character |
| idade_dias | numeric |
| resistencia_mpa | character |
| cimento_kg_m3 | character |
| relacao_a_c | character |
| abatimento_mm | numeric |
| densidade_kg_m3 | numeric |
| absorção_agregado_pct | numeric |
Dessa forma, verificou-se que idade_dias, abatimento_mm, densidade_kg_m3 e absorção_agregado_pct foram reconhecidas pelo R como variáveis numéricas. Por outro lado, id_corpo_prova, obra, tipo_concreto, resistencia_mpa, cimento_kg_m3 e relacao_a_c foram reconhecidas como texto. Entretanto, resistencia_mpa, cimento_kg_m3e relacao_a_c representam grandezas quantitativas e, portanto, indicam a possível presença de inconsistências de formatação ou digitação nessas variáveis.
Para observar se há dados ausentes, utilizou-se a função is.na() em conjunto com summarise() e across(), permitindo contabilizar a quantidade de valores ausentes em cada variável da base. Em seguida, por meio da função if_any() foram identificadas as observações que apresentam pelo menos um valor ausente.
dados |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  ) |>
  pivot_longer(
    cols = everything(),
    names_to = "Variável",
    values_to = "Valores ausentes"
  ) |>
  knitr::kable(
    caption = "Quantidade de valores ausentes por variável"
)| Variável | Valores ausentes |
|---|---|
| id_corpo_prova | 0 |
| obra | 0 |
| tipo_concreto | 0 |
| idade_dias | 0 |
| resistencia_mpa | 1 |
| cimento_kg_m3 | 0 |
| relacao_a_c | 1 |
| abatimento_mm | 1 |
| densidade_kg_m3 | 1 |
| absorção_agregado_pct | 1 |
registros_ausentes <- dados |>
  mutate(
    possui_na = if_any(
      everything(),
      is.na
    )
  ) |>
  filter(possui_na) |>
  select(-possui_na)

registros_ausentes |>
  knitr::kable(
    caption = "Observações contendo valores ausentes",
    digits = 2
)| id_corpo_prova | obra | tipo_concreto | idade_dias | resistencia_mpa | cimento_kg_m3 | relacao_a_c | abatimento_mm | densidade_kg_m3 | absorção_agregado_pct |
|---|---|---|---|---|---|---|---|---|---|
| CP-015 | Bloco B | C35 | 14 | 36.3 | 363 | 0.49 | NA | 2359 | 1.93 |
| CP-038 | Bloco C | C25 | 28 | 25.7 | 309 | NA | 146 | 2334 | 2.12 |
| CP-077 | Bloco D | C25 | 14 | 19.0 | 307 | 0.63 | 119 | NA | 1.38 |
| CP-092 | Bloco B | C35 | 14 | NA | 370 | 0.47 | 111 | 2380 | 2.38 |
| CP-097 | Bloco A | C25 | 28 | 26.7 | 356 | 0.64 | 122 | 2440 | NA |
A análise identificou cinco valores ausentes na base de dados, distribuídos entre as variáveis resistencia_mpa, relacao_a_c, abatimento_mm, densidade_kg_m3 e absorção_agregado_pct, cada uma apresentando um registro ausente. As demais variáveis não apresentaram valores ausentes.
Essa análise possibilitou localizar exatamente os corpos de prova associados a essas ausências, o que será importante para definir posteriormente o tratamento mais adequado para cada caso.
Ressalta-se uma diferença em relação ao procedimento adotado no Relatório 02, em que a base foi importada utilizando a função read.csv2(), da Base R, e os campos sem preenchimento foram mantidos como strings vazias (""), sendo necessário identificá-los por meio da comparação dados == "". No presente relatório, a importação foi realizada com a função read_delim(), do pacote readr, que reconhece os campos vazios como valores ausentes (NA). Dessa forma, a identificação das ausências pode ser realizada diretamente com is.na().
Considerando que algumas variáveis de natureza quantitativa foram reconhecidas pelo R como texto, realizou-se uma tentativa de conversão de seus valores para o formato numérico.
Para facilitar a investigação, as variáveis foram reorganizadas com pivot_longer() e convertidas temporariamente por meio de parse_double().
Foram considerados potencialmente problemáticos os registros originalmente preenchidos cuja tentativa de conversão resultou em NA, permitindo identificar automaticamente os valores incompatíveis com o formato numérico esperado.
variaveis_quantitativas_texto <- c(
  "resistencia_mpa",
  "cimento_kg_m3",
  "relacao_a_c"
)

problemas_identificados <- dados |>
  select(
    id_corpo_prova,
    all_of(variaveis_quantitativas_texto)
  ) |>
  pivot_longer(
    cols = all_of(variaveis_quantitativas_texto),
    names_to = "Variável",
    values_to = "Valor"
  ) |>
  mutate(
    valor_teste = parse_double(Valor)
  ) |>
  filter(
    !is.na(Valor) & is.na(valor_teste)
  ) |>
  select(
    id_corpo_prova,
    Variável,
    Valor
  )

problemas_identificados |>
  knitr::kable(
    caption = "Valores com inconsistências de formatação ou digitação",
    col.names = c(
      "Corpo de prova",
      "Variável",
      "Valor identificado"
    )
)| Corpo de prova | Variável | Valor identificado |
|---|---|---|
| CP-008 | resistencia_mpa | 38,7 |
| CP-019 | resistencia_mpa | 3O,4 |
| CP-045 | relacao_a_c | 0,55 |
| CP-064 | cimento_kg_m3 | 390O |
A tentativa de conversão das variáveis quantitativas originalmente reconhecidas como texto permitiu identificar quatro registros com problemas de formatação ou digitação. Nos corpos de prova CP-008, CP-019 e CP-045, foram encontrados valores com vírgula como separador decimal (38,7 e 0,55, respectivamente). Nos corpos de prova CP-019 e CP-064, foram identificados caracteres alfabéticos em valores que deveriam ser exclusivamente numéricos, correspondentes a 3O,4 e 390O, indicando a utilização da letra “O” no lugar do algarismo zero.
Para verificar se todas as categorias de obra estão escritas de forma padronizada, utilizou-se as funções count() e distinct().
dados |>
  count(obra) |>
  knitr::kable(
    caption = "Frequência das categorias da variável obra",
    col.names = c("Obra", "Frequência")
)| Obra | Frequência |
|---|---|
| Bloco A | 28 |
| Bloco B | 28 |
| Bloco B | 1 |
| Bloco C | 28 |
| Bloco D | 15 |
dados |>
  distinct(obra) |>
  arrange(obra)
# A tibble: 5 × 1
obra
<chr>
1 "Bloco A"
2 "Bloco B"
3 "Bloco B "
4 "Bloco C"
5 "Bloco D" Observa-se que a variável obra apresenta uma inconsistência de padronização, um dos registros da categoria “Bloco B” apresenta um espaço adicional ao final do texto, fazendo com que o R o reconheça como uma categoria diferente de “Bloco B”.
Já para verificar se todas as categorias da variável tipo_concreto estão escritas de forma padronizada, utilizou-se a função count().
dados |>
  count(tipo_concreto) |>
  knitr::kable(
    caption = "Frequência das categorias da variável tipo_concreto",
    col.names = c("Tipo de concreto", "Frequência")
)| Tipo de concreto | Frequência |
|---|---|
| C25 | 29 |
| C30 | 31 |
| C35 | 23 |
| C40 | 16 |
| c30 | 1 |
Assim, foram identificadas cinco categorias distintas na variável tipo_concreto: C25, C30, C35, C40 e c30. Observa-se que a categoria c30, registrada em uma única observação, representa a mesma classe de concreto que C30, diferenciando-se apenas pelo uso da letra minúscula. Dessa forma, identifica-se uma inconsistência na padronização dessa variável.
Antes de iniciar a etapa de limpeza e transformação dos dados, foi criada uma cópia da base original, denominada dados_limpos, conforme apresentado no código a seguir.
dados_limpos <- dadosImportante destacar que a preservação da base original é recomendável para garantir a rastreabilidade das alterações realizadas durante o processamento dos dados. Dessa forma, caso seja necessário revisar alguma decisão de limpeza ou comparar os valores tratados com os registros inicialmente importados, a base original permanece disponível e inalterada.
Considerando a baixa ocorrência de dados ausentes em relação ao número total de observações da base, optou-se pela exclusão das linhas que possuem alguma variável vazia. Essa abordagem permite trabalhar com observações completas nas análises subsequentes, sem a necessidade de estimar ou imputar valores não observados. Dessa forma, utilizou-se a função drop_na(), do pacote tidyr, que exclui as linhas contendo pelo menos um valor “NA”.
dados_limpos <- dados_limpos |>
  drop_na()
Para conferir o resultado aplicou-se summarise(), n() e is.na().
dados_limpos |>
  summarise(
    across(everything(), ~ sum(is.na(.x)))
  ) |>
  pivot_longer(
    cols = everything(),
    names_to = "Variável",
    values_to = "Valores ausentes"
  ) |>
  knitr::kable(
    caption = "Verificação dos valores ausentes após o tratamento",
    col.names = c("Variável", "Valores ausentes")
)| Variável | Valores ausentes |
|---|---|
| id_corpo_prova | 0 |
| obra | 0 |
| tipo_concreto | 0 |
| idade_dias | 0 |
| resistencia_mpa | 0 |
| cimento_kg_m3 | 0 |
| relacao_a_c | 0 |
| abatimento_mm | 0 |
| densidade_kg_m3 | 0 |
| absorção_agregado_pct | 0 |
Após a identificação das inconsistências de digitação e formatação nas variáveis quantitativas, realizou-se o tratamento dos registros no objeto dados_limpos. As vírgulas utilizadas como separador decimal foram substituídas por pontos. Os registros contendo a letra “O” foram tratados individualmente, considerando a natureza de cada erro: em 3O,4, a letra foi substituída pelo algarismo zero, resultando em 30.4, enquanto em 390O a letra excedente foi removida, resultando em 390.
dados_limpos <- dados_limpos |>
  mutate(
    resistencia_mpa = resistencia_mpa |>
      str_replace_all(",", ".") |>
      str_replace("3O.4", "30.4"),

    relacao_a_c = relacao_a_c |>
      str_replace_all(",", "."),

    cimento_kg_m3 = cimento_kg_m3 |>
      str_replace("390O", "390")
  )

dados_limpos <- dados_limpos |>
  mutate(
    resistencia_mpa = parse_double(resistencia_mpa),
    cimento_kg_m3 = parse_double(cimento_kg_m3),
    relacao_a_c = parse_double(relacao_a_c)
  )
A Tabela abaixo apresenta os registros após a correção das inconsistências de digitação e formatação identificadas nas variáveis quantitativas.
dados_limpos |>
  filter(
    id_corpo_prova %in% c(
      "CP-008",
      "CP-019",
      "CP-045",
      "CP-064"
    )
  ) |>
  select(
    id_corpo_prova,
    resistencia_mpa,
    cimento_kg_m3,
    relacao_a_c
  ) |>
  knitr::kable(
    caption = "Registros após a correção das inconsistências",
    col.names = c(
      "Corpo de prova",
      "Resistência (MPa)",
      "Cimento (kg/m³)",
      "Relação a/c"
    )
)| Corpo de prova | Resistência (MPa) | Cimento (kg/m³) | Relação a/c |
|---|---|---|---|
| CP-008 | 38.7 | 347 | 0.54 |
| CP-019 | 30.4 | 356 | 0.59 |
| CP-045 | 42.9 | 407 | 0.55 |
| CP-064 | 25.6 | 390 | 0.59 |
Logo, os registros anteriormente identificados com inconsistências de digitação e formatação foram corrigidos, resultando na padronização do separador decimal e na correção dos caracteres indevidamente inseridos nos valores.
Em seguida, aplicou-se a função summary() para realizar uma análise estatística dos dados.
dados_limpos |>
  summary()
id_corpo_prova obra tipo_concreto idade_dias
Length :95 Length :95 Length :95 Min. : 7.00
N.unique :95 N.unique : 5 N.unique : 5 1st Qu.: 14.00
N.blank : 0 N.blank : 0 N.blank : 0 Median : 28.00
Min.nchar: 6 Min.nchar: 7 Min.nchar: 3 Mean : 28.44
Max.nchar: 6 Max.nchar: 8 Max.nchar: 3 3rd Qu.: 28.00
Max. :280.00
resistencia_mpa cimento_kg_m3 relacao_a_c abatimento_mm
Min. :21.30 Min. :295.0 Min. :0.4300 Min. : 64.0
1st Qu.:29.30 1st Qu.:340.0 1st Qu.:0.5100 1st Qu.: 99.0
Median :32.70 Median :353.0 Median :0.5600 Median : 109.0
Mean :33.83 Mean :358.5 Mean :0.5536 Mean : 121.6
3rd Qu.:38.55 3rd Qu.:385.0 3rd Qu.:0.5950 3rd Qu.: 122.5
Max. :47.50 Max. :418.0 Max. :0.6500 Max. :1250.0
densidade_kg_m3 absorção_agregado_pct
Min. : 238 Min. : 0.800
1st Qu.:2348 1st Qu.: 1.475
Median :2374 Median : 1.830
Mean :2350 Mean : 1.953
3rd Qu.:2388 3rd Qu.: 2.100
Max. :2464 Max. :18.400 Observa-se, ainda, alguns valores suspeitos:
idade_dias: máximo = 280, fora do padrão de idades obsevados (7, 14, 28, 56);abatimento_mm: máximo = 12.500, muito acima da média e mediana observadas;densidade_kg_m3: mínimo = 238, muito abaixo da média e mediana observadas;absorção_agregado_pct: máximo = 18,4, muito acima da média e mediana observadas.Considerando que possivelmente foram erros de digitação ao preencher os dados, fez-se os devidos ajustes.
dados_limpos <- dados_limpos |>
  mutate(
    idade_dias = if_else(
      id_corpo_prova == "CP-085", 28, idade_dias
    ),
    abatimento_mm = if_else(
      id_corpo_prova == "CP-032", 125, abatimento_mm
    ),
    densidade_kg_m3 = if_else(
      id_corpo_prova == "CP-053", 2380, densidade_kg_m3
    ),
    absorção_agregado_pct = if_else(
      id_corpo_prova == "CP-072", 1.84, absorção_agregado_pct
    )
)dados_limpos |>
filter(
id_corpo_prova %in% c(
"CP-032",
"CP-053",
"CP-072",
"CP-085"
)
) |>
select(
id_corpo_prova,
idade_dias,
abatimento_mm,
densidade_kg_m3,
absorção_agregado_pct
) |>
knitr::kable(
caption = "Registros após a correção dos valores inconsistentes",
col.names = c(
"Corpo de prova",
"Idade (dias)",
"Abatimento (mm)",
"Densidade (kg/m³)",
"Absorção (%)"
),
digits = 2
)| Corpo de prova | Idade (dias) | Abatimento (mm) | Densidade (kg/m³) | Absorção (%) |
|---|---|---|---|---|
| CP-032 | 14 | 125 | 2383 | 2.13 |
| CP-053 | 28 | 97 | 2380 | 1.79 |
| CP-072 | 14 | 98 | 2414 | 1.84 |
| CP-085 | 28 | 141 | 2377 | 1.86 |
Para as variáveis qualitativas obra e tipo_concreto, foram identificadas inconsistências de padronização. Na variável obra, foi identificado um espaço adicional ao final de um dos registros da categoria “Bloco B”, enquanto, para tipo_concreto, foi identificada a categoria c30 escrita com letra minúscula. Para a correção, utilizaram-se as funções str_trim() e str_to_upper(), do pacote stringr, respectivamente.
dados_limpos <- dados_limpos |>
  mutate(
    obra = str_trim(obra),
    tipo_concreto = str_to_upper(tipo_concreto)
  )

dados_limpos |>
  count(obra) |>
  knitr::kable(
    caption = "Categorias da variável obra após a padronização",
    col.names = c("Obra", "Frequência")
)| Obra | Frequência |
|---|---|
| Bloco A | 27 |
| Bloco B | 27 |
| Bloco C | 27 |
| Bloco D | 14 |
dados_limpos |>
  count(tipo_concreto) |>
  knitr::kable(
    caption = "Categorias da variável tipo_concreto após a padronização",
    col.names = c("Tipo de concreto", "Frequência")
)| Tipo de concreto | Frequência |
|---|---|
| C25 | 26 |
| C30 | 32 |
| C35 | 21 |
| C40 | 16 |
Dessa forma, ambas as variáveis qualitativas passaram a apresentar categorias consistentes e adequadamente padronizadas.
Após a realização das etapas de tratamento e correção das inconsistências identificadas, obteve-se a base de dados limpa, cuja estrutura e estatísticas descritivas são apresentadas a seguir.
dados_limpos |>
  glimpse()
Rows: 95
Columns: 10
$ id_corpo_prova <chr> "CP-001", "CP-002", "CP-003", "CP-004", "CP-005"…
$ obra <chr> "Bloco A", "Bloco A", "Bloco C", "Bloco A", "Blo…
$ tipo_concreto <chr> "C35", "C30", "C30", "C40", "C25", "C40", "C25",…
$ idade_dias <dbl> 28, 7, 56, 28, 28, 28, 56, 28, 14, 7, 7, 28, 28,…
$ resistencia_mpa <dbl> 36.3, 28.4, 36.1, 47.2, 27.9, 41.5, 23.7, 38.7, …
$ cimento_kg_m3 <dbl> 395, 340, 338, 407, 316, 398, 351, 347, 346, 315…
$ relacao_a_c <dbl> 0.50, 0.54, 0.56, 0.47, 0.61, 0.43, 0.65, 0.54, …
$ abatimento_mm <dbl> 111, 114, 106, 142, 133, 98, 99, 116, 125, 127, …
$ densidade_kg_m3 <dbl> 2332, 2389, 2427, 2345, 2448, 2324, 2385, 2387, …
$ absorção_agregado_pct <dbl> 2.30, 1.85, 1.89, 1.97, 2.31, 0.80, 1.18, 1.33, …dados_limpos |>
summary() id_corpo_prova obra tipo_concreto idade_dias
Length :95 Length :95 Length :95 Min. : 7.00
N.unique :95 N.unique : 4 N.unique : 4 1st Qu.:14.00
N.blank : 0 N.blank : 0 N.blank : 0 Median :28.00
Min.nchar: 6 Min.nchar: 7 Min.nchar: 3 Mean :25.79
Max.nchar: 6 Max.nchar: 7 Max.nchar: 3 3rd Qu.:28.00
Max. :56.00
resistencia_mpa cimento_kg_m3 relacao_a_c abatimento_mm
Min. :21.30 Min. :295.0 Min. :0.4300 Min. : 64.0
1st Qu.:29.30 1st Qu.:340.0 1st Qu.:0.5100 1st Qu.: 99.0
Median :32.70 Median :353.0 Median :0.5600 Median :109.0
Mean :33.83 Mean :358.5 Mean :0.5536 Mean :109.7
3rd Qu.:38.55 3rd Qu.:385.0 3rd Qu.:0.5950 3rd Qu.:122.5
Max. :47.50 Max. :418.0 Max. :0.6500 Max. :175.0
densidade_kg_m3 absorção_agregado_pct
Min. :2293 Min. :0.800
1st Qu.:2348 1st Qu.:1.475
Median :2374 Median :1.830
Mean :2373 Mean :1.779
3rd Qu.:2388 3rd Qu.:2.095
Max. :2464 Max. :2.920 Após o processo de limpeza, a base passou a apresentar 95 observações e 10 variáveis. As variáveis quantitativas foram adequadamente convertidas para o tipo numérico (<dbl>), permitindo a obtenção de suas estatísticas descritivas. Além disso, foram corrigidas as inconsistências de digitação e formatação previamente identificadas, bem como a padronização da variável qualitativa tipo_concreto. Os registros contendo valores ausentes foram removidos, reduzindo a base original de 100 para 95 observações.
A análise do resumo da base após o tratamento também demonstra a correção dos valores considerados inconsistentes. A idade máxima dos corpos de prova passou a ser 56 dias, o abatimento máximo 175 mm, a densidade passou a apresentar valores compatíveis com a ordem de grandeza dos demais registros e a absorção máxima foi reduzida após a correção do valor discrepante. Dessa forma, a base dados_limpos encontra-se estruturada para realização das análises estatísticas.
Com o objetivo de avaliar o comportamento da resistência à compressão dos corpos de prova, inicialmente foi calculada a resistência média considerando o conjunto total de observações. Posteriormente, os dados foram agrupados por bloco da obra, tipo de concreto e idade do corpo de prova, utilizando-se as funções group_by() e summarise() do pacote dplyr.
dados_limpos |>
summarise(
resistencia_media = mean(resistencia_mpa)
) |>
knitr::kable(
caption = "Resistência média à compressão dos corpos de prova geral",
col.names = "Resistência média (MPa)",
digits = 2
)| Resistência média (MPa) |
|---|
| 33.83 |
dados_limpos |>
group_by(obra) |>
summarise(
resistencia_media = mean(resistencia_mpa)
) |>
knitr::kable(
caption = "Resistência média à compressão por bloco da obra",
col.names = c("Obra", "Resistência média (MPa)"),
digits = 2
)| Obra | Resistência média (MPa) |
|---|---|
| Bloco A | 33.43 |
| Bloco B | 35.68 |
| Bloco C | 32.62 |
| Bloco D | 33.35 |
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
resistencia_media = mean(resistencia_mpa)
) |>
knitr::kable(
caption = "Resistência média à compressão por tipo de concreto",
col.names = c("Tipo de concreto", "Resistência média (MPa)"),
digits = 2
)| Tipo de concreto | Resistência média (MPa) |
|---|---|
| C25 | 27.45 |
| C30 | 32.08 |
| C35 | 37.14 |
| C40 | 43.33 |
dados_limpos |>
group_by(idade_dias) |>
summarise(
resistencia_media = mean(resistencia_mpa)
) |>
arrange(idade_dias) |>
knitr::kable(
caption = "Resistência média à compressão por idade do corpo de prova",
col.names = c("Idade (dias)", "Resistência média (MPa)"),
digits = 2
)| Idade (dias) | Resistência média (MPa) |
|---|---|
| 7 | 28.78 |
| 14 | 35.83 |
| 28 | 34.96 |
| 56 | 33.12 |
Para comparar os blocos da obra quanto à resistência à compressão, calculou-se a resistência média dos corpos de prova para cada bloco por meio das funções group_by() e summarise(). Posteriormente, os resultados foram ordenados de forma decrescente utilizando arrange(), permitindo identificar os blocos que apresentaram a maior e a menor resistência média.
dados_limpos |>
group_by(obra) |>
summarise(
resistencia_media = mean(resistencia_mpa)
) |>
arrange(desc(resistencia_media)) |>
knitr::kable(
caption = "Resistência média à compressão por bloco da obra",
col.names = c(
"Obra",
"Resistência média (MPa)"
),
digits = 2
)| Obra | Resistência média (MPa) |
|---|---|
| Bloco B | 35.68 |
| Bloco A | 33.43 |
| Bloco D | 33.35 |
| Bloco C | 32.62 |
Conforme apresentado na tabela, o Bloco B apresentou a maior resistência média à compressão, com 35,68 MPa, enquanto o Bloco C apresentou a menor resistência média, com 32,62 MPa. Os Blocos A e D apresentaram valores intermediários, de 33,43 MPa e 33,35 MPa.
Para avaliar a resistência à compressão em função da classe do concreto, calculou-se a resistência média dos corpos de prova para cada categoria de tipo_concreto. Os dados foram agrupados por classe e, posteriormente, ordenados de forma decrescente de acordo com a resistência média obtida.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
resistencia_media = mean(resistencia_mpa)
) |>
arrange(desc(resistencia_media)) |>
knitr::kable(
caption = "Resistência média à compressão por tipo de concreto",
col.names = c(
"Tipo de concreto",
"Resistência média (MPa)"
),
digits = 2
)| Tipo de concreto | Resistência média (MPa) |
|---|---|
| C40 | 43.33 |
| C35 | 37.14 |
| C30 | 32.08 |
| C25 | 27.45 |
Conforme apresentado na tabela, a classe C40 apresentou a maior resistência média à compressão, com 43,33 MPa, seguida pelas classes C35, C30 e C25, com resistências médias de 37,14 MPa, 32,08 MPa e 27,45 MPa, respectivamente. Observa-se, portanto, um aumento da resistência média à compressão conforme aumenta a classe de resistência do concreto, comportamento compatível com a classificação adotada para os diferentes tipos de concreto.
Para comparar as características médias das diferentes classes de concreto, os dados foram agrupados por tipo_concreto utilizando group_by(). Em seguida, utilizou-se summarise() em conjunto com across() para calcular simultaneamente os valores médios de resistência à compressão, consumo de cimento, relação água/cimento, abatimento e densidade.
medias_tipo_concreto <- dados_limpos |>
group_by(tipo_concreto) |>
summarise(
across(
c(
resistencia_mpa,
cimento_kg_m3,
relacao_a_c,
abatimento_mm,
densidade_kg_m3
),
mean
),
.groups = "drop"
)
medias_tipo_concreto |>
knitr::kable(
caption = "Valores médios das variáveis por tipo de concreto",
col.names = c(
"Tipo de concreto",
"Resistência (MPa)",
"Cimento (kg/m³)",
"Relação a/c",
"Abatimento (mm)",
"Densidade (kg/m³)"
),
digits = 2
)| Tipo de concreto | Resistência (MPa) | Cimento (kg/m³) | Relação a/c | Abatimento (mm) | Densidade (kg/m³) |
|---|---|---|---|---|---|
| C25 | 27.45 | 322.35 | 0.62 | 113.58 | 2374.00 |
| C30 | 32.08 | 351.44 | 0.57 | 110.72 | 2383.47 |
| C35 | 37.14 | 379.24 | 0.51 | 107.14 | 2363.29 |
| C40 | 43.33 | 404.12 | 0.48 | 104.94 | 2362.50 |
Os resultados mostram que o aumento da classe do concreto está associado ao aumento da resistência média à compressão e do consumo médio de cimento. A resistência média aumentou de 27,45 MPa, para o concreto C25, para 43,33 MPa, no C40, enquanto o consumo médio de cimento passou de 322,35 kg/m³ para 404,12 kg/m³.
Em relação à razão água/cimento, observa-se comportamento inverso, com redução de 0,62 no C25 para 0,48 no C40. O abatimento médio também apresentou redução gradual entre as classes, variando de 113,58 mm no C25 a 104,94 mm no C40. Por outro lado, a densidade apresentou valores relativamente próximos entre as classes, variando entre 2.362,50 e 2.383,47 kg/m³. De modo geral, os resultados evidenciam diferenças nas características médias dos concretos em função de suas respectivas classes.
Para o cálculo da resistência relativa, adotou-se como resistência de referência o valor correspondente à classe de resistência de cada concreto, sendo 25 MPa para C25, 30 MPa para C30, 35 MPa para C35 e 40 MPa para C40. A variável resistencia_referencia foi definida utilizando-se a função case_when(), enquanto a variável resistencia_relativa foi obtida pela razão entre a resistência à compressão observada e a respectiva resistência de referência.
dados_limpos <- dados_limpos |>
mutate(
resistencia_referencia = case_when(
tipo_concreto == "C25" ~ 25,
tipo_concreto == "C30" ~ 30,
tipo_concreto == "C35" ~ 35,
tipo_concreto == "C40" ~ 40
),
resistencia_relativa = resistencia_mpa / resistencia_referencia
)
dados_limpos <- dados_limpos |>
select(-resistencia_referencia)
dados_limpos |>
select(
id_corpo_prova,
tipo_concreto,
resistencia_mpa,
resistencia_relativa
) |>
slice_head(n = 10) |>
knitr::kable(
caption = "Resistência relativa dos corpos de prova",
col.names = c(
"Corpo de prova",
"Tipo de concreto",
"Resistência (MPa)",
"Resistência relativa"
),
digits = 2
)| Corpo de prova | Tipo de concreto | Resistência (MPa) | Resistência relativa |
|---|---|---|---|
| CP-001 | C35 | 36.3 | 1.04 |
| CP-002 | C30 | 28.4 | 0.95 |
| CP-003 | C30 | 36.1 | 1.20 |
| CP-004 | C40 | 47.2 | 1.18 |
| CP-005 | C25 | 27.9 | 1.12 |
| CP-006 | C40 | 41.5 | 1.04 |
| CP-007 | C25 | 23.7 | 0.95 |
| CP-008 | C30 | 38.7 | 1.29 |
| CP-009 | C30 | 30.3 | 1.01 |
| CP-010 | C25 | 25.3 | 1.01 |
A resistência relativa permite comparar a resistência observada com a resistência de referência de cada classe de concreto. Valores superiores a 1,00 indicam resistência acima da referência, enquanto valores inferiores a 1,00 indicam resistência abaixo da referência.
Para a classificação dos corpos de prova, utilizou-se como critério a resistência relativa calculada anteriormente. Os corpos de prova com resistência relativa inferior a 1 foram classificados como “Abaixo da referência”, enquanto aqueles com valor igual ou superior a 1 foram classificados como “Atende ou supera a referência”. Esse critério permite avaliar a resistência observada em relação ao valor de referência adotado para cada classe de concreto.
dados_limpos <- dados_limpos |>
mutate(
classificacao = case_when(
resistencia_relativa < 1 ~ "Abaixo da referência",
resistencia_relativa >= 1 ~ "Atende ou supera a referência"
)
)
dados_limpos |>
count(classificacao) |>
knitr::kable(
caption = "Classificação dos corpos de prova quanto à resistência",
col.names = c("Classificação", "Frequência")
)| Classificação | Frequência |
|---|---|
| Abaixo da referência | 23 |
| Atende ou supera a referência | 72 |
Com base nos resultados, dos 95 corpos de prova analisados, 72 atenderam ou superaram a resistência de referência, enquanto 23 apresentaram resistência abaixo da referência. Dessa forma, observa-se predominância de corpos de prova com resistência igual ou superior ao valor adotado como referência para sua respectiva classe de concreto.
Para verificar se a resistência de cada corpo de prova se encontra acima da média de sua respectiva classe de concreto, os dados foram agrupados por tipo_concreto. Em seguida, utilizou-se mutate() para criar a variável lógica acima_media, que assume TRUE quando a resistência observada é superior à média do grupo e FALSE caso contrário.
dados_limpos <- dados_limpos |>
group_by(tipo_concreto) |>
mutate(
acima_media = resistencia_mpa > mean(resistencia_mpa)
) |>
ungroup()
dados_limpos |>
count(tipo_concreto, acima_media) |>
knitr::kable(
caption = "Classificação dos corpos de prova em relação à média de sua classe",
col.names = c(
"Tipo de concreto",
"Acima da média",
"Frequência"
)
)| Tipo de concreto | Acima da média | Frequência |
|---|---|---|
| C25 | FALSE | 10 |
| C25 | TRUE | 16 |
| C30 | FALSE | 17 |
| C30 | TRUE | 15 |
| C35 | FALSE | 12 |
| C35 | TRUE | 9 |
| C40 | FALSE | 8 |
| C40 | TRUE | 8 |
A variável acima_media permitiu identificar a distribuição dos corpos de prova em relação à resistência média de cada classe de concreto. Para as classes C25, C30, C35 e C40, foram identificados, respectivamente, 16, 15, 9 e 8 corpos de prova com resistência superior à média de sua respectiva classe.
Para verificar a distribuição das observações entre as diferentes classes de concreto, os dados foram agrupados pela variável tipo_concreto. Em seguida, utilizou-se summarise() em conjunto com n() para determinar a quantidade de corpos de prova pertencentes a cada classe.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
quantidade = n()
) |>
knitr::kable(
caption = "Quantidade de observações por tipo de concreto",
col.names = c(
"Tipo de concreto",
"Quantidade de observações"
)
)| Tipo de concreto | Quantidade de observações |
|---|---|
| C25 | 26 |
| C30 | 32 |
| C35 | 21 |
| C40 | 16 |
A distribuição dos corpos de prova entre as classes de concreto não é uniforme. A classe C30 apresentou o maior número de observações, com 32 registros, seguida pelas classes C25, com 26, C35, com 21, e C40, com 16 observações.
Para comparar a resistência média entre as diferentes classes de concreto, os dados foram agrupados por tipo_concreto e resumidos por meio das funções group_by() e summarise(). Posteriormente, utilizou-se arrange() para ordenar os resultados de forma decrescente em relação à resistência média.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
resistencia_media = mean(resistencia_mpa)
) |>
arrange(desc(resistencia_media)) |>
knitr::kable(
caption = "Resistência média por tipo de concreto",
col.names = c(
"Tipo de concreto",
"Resistência média (MPa)"
),
digits = 2
)| Tipo de concreto | Resistência média (MPa) |
|---|---|
| C40 | 43.33 |
| C35 | 37.14 |
| C30 | 32.08 |
| C25 | 27.45 |
Assim como visto anteriormente, a classe C40 apresenta a maior resistência média, seguida pelas classes C35, C30 e C25, com 43,33 MPa, 37,14 MPa, 32,08 MPa e 27,45 MPa, respectivamente.
Para caracterizar a distribuição da resistência à compressão em cada classe de concreto, foram calculados o número de observações, a média, a mediana, o desvio-padrão e os valores mínimo e máximo. Para isso, os dados foram agrupados por tipo_concreto e as estatísticas foram obtidas simultaneamente por meio da função summarise().
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
quantidade = n(),
media = mean(resistencia_mpa),
mediana = median(resistencia_mpa),
desvio_padrao = sd(resistencia_mpa),
minimo = min(resistencia_mpa),
maximo = max(resistencia_mpa)
) |>
knitr::kable(
caption = "Estatísticas da resistência por tipo de concreto",
col.names = c(
"Tipo de concreto",
"N",
"Média (MPa)",
"Mediana (MPa)",
"Desvio-padrão (MPa)",
"Mínimo (MPa)",
"Máximo (MPa)"
),
digits = 2
)| Tipo de concreto | N | Média (MPa) | Mediana (MPa) | Desvio-padrão (MPa) | Mínimo (MPa) | Máximo (MPa) |
|---|---|---|---|---|---|---|
| C25 | 26 | 27.45 | 27.95 | 2.77 | 21.3 | 31.6 |
| C30 | 32 | 32.08 | 31.80 | 3.57 | 24.5 | 39.4 |
| C35 | 21 | 37.14 | 36.90 | 3.77 | 29.9 | 44.6 |
| C40 | 16 | 43.33 | 43.15 | 3.08 | 37.3 | 47.5 |
Observa-se que as médias e medianas apresentam valores próximos em todas as classes de concreto, indicando pouca diferença entre essas medidas de tendência central. Os desvios-padrão variaram entre 2,77 MPa e 3,77 MPa, sendo a classe C35 a que apresentou maior dispersão dos valores de resistência e a classe C25 a menor. Além disso, verifica-se o aumento dos valores de resistência à compressão, incluindo mínimos e máximos, conforme aumenta a classe do concreto.
Complementarmente, uma tabela com várias estatísticas é mais informativa do que a apresentação apenas da média, pois permite avaliar não somente o valor central dos dados, mas também sua dispersão e amplitude. A mediana possibilita comparar a tendência central com a média, o desvio-padrão indica a variabilidade dos resultados e os valores mínimo e máximo mostram os extremos observados. Dessa forma, é possível obter uma caracterização mais completa da resistência à compressão em cada classe de concreto.
Para a continuidade das análises, foram selecionadas somente as variáveis quantitativas relacionadas às propriedades do concreto. Para isso, utilizou-se a função select() em conjunto com all_of(), permitindo selecionar as variáveis previamente definidas como de interesse.
variaveis_quantitativas <- c(
"idade_dias",
"resistencia_mpa",
"cimento_kg_m3",
"relacao_a_c",
"abatimento_mm",
"densidade_kg_m3",
"absorção_agregado_pct"
)
dados_quantitativos <- dados_limpos |>
select(all_of(variaveis_quantitativas))A tabela a seguir apresenta as primeiras observações da nova base formada exclusivamente pelas variáveis quantitativas selecionadas.
dados_quantitativos |>
slice_head(n = 10) |>
knitr::kable(
caption = "Variáveis quantitativas relacionadas às propriedades do concreto",
col.names = c(
"Idade (dias)",
"Resistência (MPa)",
"Cimento (kg/m³)",
"Relação a/c",
"Abatimento (mm)",
"Densidade (kg/m³)",
"Absorção (%)"
),
digits = 2
)| Idade (dias) | Resistência (MPa) | Cimento (kg/m³) | Relação a/c | Abatimento (mm) | Densidade (kg/m³) | Absorção (%) |
|---|---|---|---|---|---|---|
| 28 | 36.3 | 395 | 0.50 | 111 | 2332 | 2.30 |
| 7 | 28.4 | 340 | 0.54 | 114 | 2389 | 1.85 |
| 56 | 36.1 | 338 | 0.56 | 106 | 2427 | 1.89 |
| 28 | 47.2 | 407 | 0.47 | 142 | 2345 | 1.97 |
| 28 | 27.9 | 316 | 0.61 | 133 | 2448 | 2.31 |
| 28 | 41.5 | 398 | 0.43 | 98 | 2324 | 0.80 |
| 56 | 23.7 | 351 | 0.65 | 99 | 2385 | 1.18 |
| 28 | 38.7 | 347 | 0.54 | 116 | 2387 | 1.33 |
| 14 | 30.3 | 346 | 0.54 | 125 | 2328 | 2.92 |
| 7 | 25.3 | 315 | 0.60 | 127 | 2413 | 1.94 |
Para calcular simultaneamente a média das variáveis quantitativas selecionadas, utilizou-se a função across() em conjunto com summarise(). Essa abordagem permite aplicar a mesma função a diversas variáveis sem a necessidade de especificar individualmente o cálculo para cada coluna.
dados_quantitativos |>
summarise(
across(
everything(),
mean
)
) |>
pivot_longer(
everything(),
names_to = "Variável",
values_to = "Média"
) |>
knitr::kable(
caption = "Média das variáveis quantitativas",
col.names = c("Variável", "Média"),
digits = 2
)| Variável | Média |
|---|---|
| idade_dias | 25.79 |
| resistencia_mpa | 33.83 |
| cimento_kg_m3 | 358.49 |
| relacao_a_c | 0.55 |
| abatimento_mm | 109.74 |
| densidade_kg_m3 | 2372.88 |
| absorção_agregado_pct | 1.78 |
Em comparação com o uso individual de summarise(), a utilização de across() torna o código mais compacto e facilita sua manutenção, principalmente quando há um grande número de variáveis. Caso novas variáveis sejam incluídas na seleção, a mesma operação pode ser aplicada a elas sem a necessidade de acrescentar manualmente novos cálculos. Dessa forma, across() apresenta maior praticidade e facilidade de manutenção para esse tipo de análise.
Para realizar uma transformação simultânea em diferentes variáveis quantitativas, utilizou-se mutate() em conjunto com across(). Os valores de resistência, consumo de cimento, abatimento e densidade foram divididos pelas respectivas médias, gerando variáveis relativas. Essa transformação permite comparar valores que apresentam diferentes unidades e ordens de grandeza em uma escala comum, na qual valores iguais a 1 correspondem à média de cada variável.
dados_transformados <- dados_limpos |>
mutate(
across(
c(
resistencia_mpa,
cimento_kg_m3,
abatimento_mm,
densidade_kg_m3
),
~ .x / mean(.x),
.names = "{.col}_relativo"
)
)
dados_transformados |>
select(
id_corpo_prova,
ends_with("_relativo")
) |>
slice_head(n = 10) |>
knitr::kable(
caption = "Variáveis quantitativas transformadas em relação às respectivas médias",
digits = 2
)| id_corpo_prova | resistencia_mpa_relativo | cimento_kg_m3_relativo | abatimento_mm_relativo | densidade_kg_m3_relativo |
|---|---|---|---|---|
| CP-001 | 1.07 | 1.10 | 1.01 | 0.98 |
| CP-002 | 0.84 | 0.95 | 1.04 | 1.01 |
| CP-003 | 1.07 | 0.94 | 0.97 | 1.02 |
| CP-004 | 1.40 | 1.14 | 1.29 | 0.99 |
| CP-005 | 0.82 | 0.88 | 1.21 | 1.03 |
| CP-006 | 1.23 | 1.11 | 0.89 | 0.98 |
| CP-007 | 0.70 | 0.98 | 0.90 | 1.01 |
| CP-008 | 1.14 | 0.97 | 1.06 | 1.01 |
| CP-009 | 0.90 | 0.97 | 1.14 | 0.98 |
| CP-010 | 0.75 | 0.88 | 1.16 | 1.02 |
A transformação permitiu expressar os valores das diferentes propriedades em relação às respectivas médias. Dessa forma, valores superiores a 1 indicam resultados acima da média da variável analisada, enquanto valores inferiores a 1 representam resultados abaixo da média. Essa padronização facilita a comparação entre propriedades que possuem diferentes unidades e ordens de grandeza.
Na sequência, foram calculadas simultaneamente a média e o desvio-padrão das variáveis quantitativas para cada tipo de concreto. Para isso, utilizou-se group_by() para o agrupamento das observações e summarise() em conjunto com across(), permitindo aplicar as mesmas funções estatísticas a diferentes variáveis.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
across(
c(
idade_dias,
resistencia_mpa,
cimento_kg_m3,
relacao_a_c,
abatimento_mm,
densidade_kg_m3,
absorção_agregado_pct
),
list(
media = mean,
desvio_padrao = sd
),
.names = "{.col}_{.fn}"
)
) |>
pivot_longer(
cols = -tipo_concreto,
names_to = c("Variavel", ".value"),
names_pattern = "(.*)_(media|desvio_padrao)"
) |>
knitr::kable(
caption = "Média e desvio-padrão das variáveis quantitativas por tipo de concreto",
digits = 2
)| tipo_concreto | Variavel | media | desvio_padrao |
|---|---|---|---|
| C25 | idade_dias | 27.73 | 14.88 |
| C25 | resistencia_mpa | 27.45 | 2.77 |
| C25 | cimento_kg_m3 | 322.35 | 14.84 |
| C25 | relacao_a_c | 0.62 | 0.02 |
| C25 | abatimento_mm | 113.58 | 21.58 |
| C25 | densidade_kg_m3 | 2374.00 | 31.90 |
| C25 | absorção_agregado_pct | 1.92 | 0.35 |
| C30 | idade_dias | 25.81 | 15.95 |
| C30 | resistencia_mpa | 32.08 | 3.57 |
| C30 | cimento_kg_m3 | 351.44 | 12.24 |
| C30 | relacao_a_c | 0.57 | 0.02 |
| C30 | abatimento_mm | 110.72 | 16.55 |
| C30 | densidade_kg_m3 | 2383.47 | 38.26 |
| C30 | absorção_agregado_pct | 1.63 | 0.52 |
| C35 | idade_dias | 25.33 | 12.81 |
| C35 | resistencia_mpa | 37.14 | 3.77 |
| C35 | cimento_kg_m3 | 379.24 | 12.41 |
| C35 | relacao_a_c | 0.51 | 0.03 |
| C35 | abatimento_mm | 107.14 | 20.48 |
| C35 | densidade_kg_m3 | 2363.29 | 33.09 |
| C35 | absorção_agregado_pct | 1.85 | 0.43 |
| C40 | idade_dias | 23.19 | 7.55 |
| C40 | resistencia_mpa | 43.33 | 3.08 |
| C40 | cimento_kg_m3 | 404.12 | 6.67 |
| C40 | relacao_a_c | 0.48 | 0.03 |
| C40 | abatimento_mm | 104.94 | 21.55 |
| C40 | densidade_kg_m3 | 2362.50 | 28.02 |
| C40 | absorção_agregado_pct | 1.75 | 0.41 |
Em comparação com a utilização de vários comandos separados, o uso de across() torna o código mais compacto e facilita sua manutenção, pois permite aplicar simultaneamente as mesmas funções a um conjunto de variáveis. Dessa forma, caso seja necessário incluir novas variáveis ou estatísticas na análise, a alteração pode ser realizada em um único trecho do código, reduzindo repetições e tornando a análise mais organizada.
Na sequência, foram avaliados os valores da variável obra com o objetivo de identificar possíveis inconsistências textuais. Para a padronização, utilizaram-se funções do pacote stringr, removendo espaços excedentes no início ou no final dos textos e uniformizando o uso de letras maiúsculas e minúsculas.
dados_limpos <- dados_limpos |>
mutate(
obra = str_trim(obra),
obra = str_to_title(obra)
)
dados |>
transmute(
Antes = obra,
Depois = str_to_title(str_trim(obra))
) |>
distinct()# A tibble: 5 × 2
Antes Depois
<chr> <chr>
1 "Bloco A" Bloco A
2 "Bloco C" Bloco C
3 "Bloco B" Bloco B
4 "Bloco D" Bloco D
5 "Bloco B " Bloco BApós a padronização, os valores da variável obra passaram a apresentar uma estrutura textual uniforme, reduzindo o risco de que diferenças de formatação sejam interpretadas como categorias distintas durante as análises.
Na sequência, utilizou-se a função str_detect() para localizar os registros que apresentam o padrão textual “Bloco B” na variável obra. A função identifica a presença do padrão especificado e, em conjunto com filter(), permite selecionar apenas as observações correspondentes.
dados_limpos |>
filter(
str_detect(obra, "Bloco B")
) |>
select(
id_corpo_prova,
obra,
tipo_concreto,
resistencia_mpa
) |>
knitr::kable(
caption = "Registros identificados pelo padrão textual 'Bloco B'",
col.names = c(
"Corpo de prova",
"Obra",
"Tipo de concreto",
"Resistência (MPa)"
),
digits = 2
)| Corpo de prova | Obra | Tipo de concreto | Resistência (MPa) |
|---|---|---|---|
| CP-005 | Bloco B | C25 | 27.9 |
| CP-006 | Bloco B | C40 | 41.5 |
| CP-009 | Bloco B | C30 | 30.3 |
| CP-013 | Bloco B | C35 | 35.6 |
| CP-014 | Bloco B | C35 | 39.4 |
| CP-017 | Bloco B | C35 | 38.4 |
| CP-018 | Bloco B | C30 | 34.7 |
| CP-019 | Bloco B | C30 | 30.4 |
| CP-020 | Bloco B | C40 | 41.7 |
| CP-027 | Bloco B | C30 | 39.4 |
| CP-030 | Bloco B | C35 | 44.6 |
| CP-035 | Bloco B | C35 | 41.1 |
| CP-037 | Bloco B | C30 | 36.6 |
| CP-040 | Bloco B | C25 | 29.4 |
| CP-042 | Bloco B | C30 | 32.3 |
| CP-047 | Bloco B | C25 | 26.2 |
| CP-048 | Bloco B | C30 | 32.1 |
| CP-056 | Bloco B | C35 | 37.9 |
| CP-057 | Bloco B | C30 | 33.5 |
| CP-059 | Bloco B | C30 | 29.9 |
| CP-063 | Bloco B | C35 | 36.2 |
| CP-072 | Bloco B | C40 | 37.3 |
| CP-074 | Bloco B | C25 | 27.8 |
| CP-080 | Bloco B | C35 | 35.1 |
| CP-081 | Bloco B | C40 | 47.5 |
| CP-088 | Bloco B | C35 | 36.9 |
| CP-091 | Bloco B | C35 | 39.6 |
Além disso, a utilização de padrões de texto auxilia no diagnóstico de bases de dados, permitindo localizar categorias específicas e identificar possíveis inconsistências de preenchimento, como diferenças de grafia, uso de letras maiúsculas e minúsculas ou caracteres indesejados. Essa verificação contribui para a padronização e maior consistência dos dados antes das análises.
Para comparar a distribuição da resistência à compressão entre as diferentes classes de concreto, foi elaborado um gráfico do tipo boxplot. Essa representação permite visualizar a posição central dos dados, sua dispersão e possíveis valores extremos em cada grupo.
ggplot(
dados_limpos,
aes(
x = tipo_concreto,
y = resistencia_mpa
)
) +
geom_boxplot() +
labs(
title = "Distribuição da resistência à compressão por tipo de concreto",
x = "Tipo de concreto",
y = "Resistência à compressão (MPa)"
) +
theme_minimal()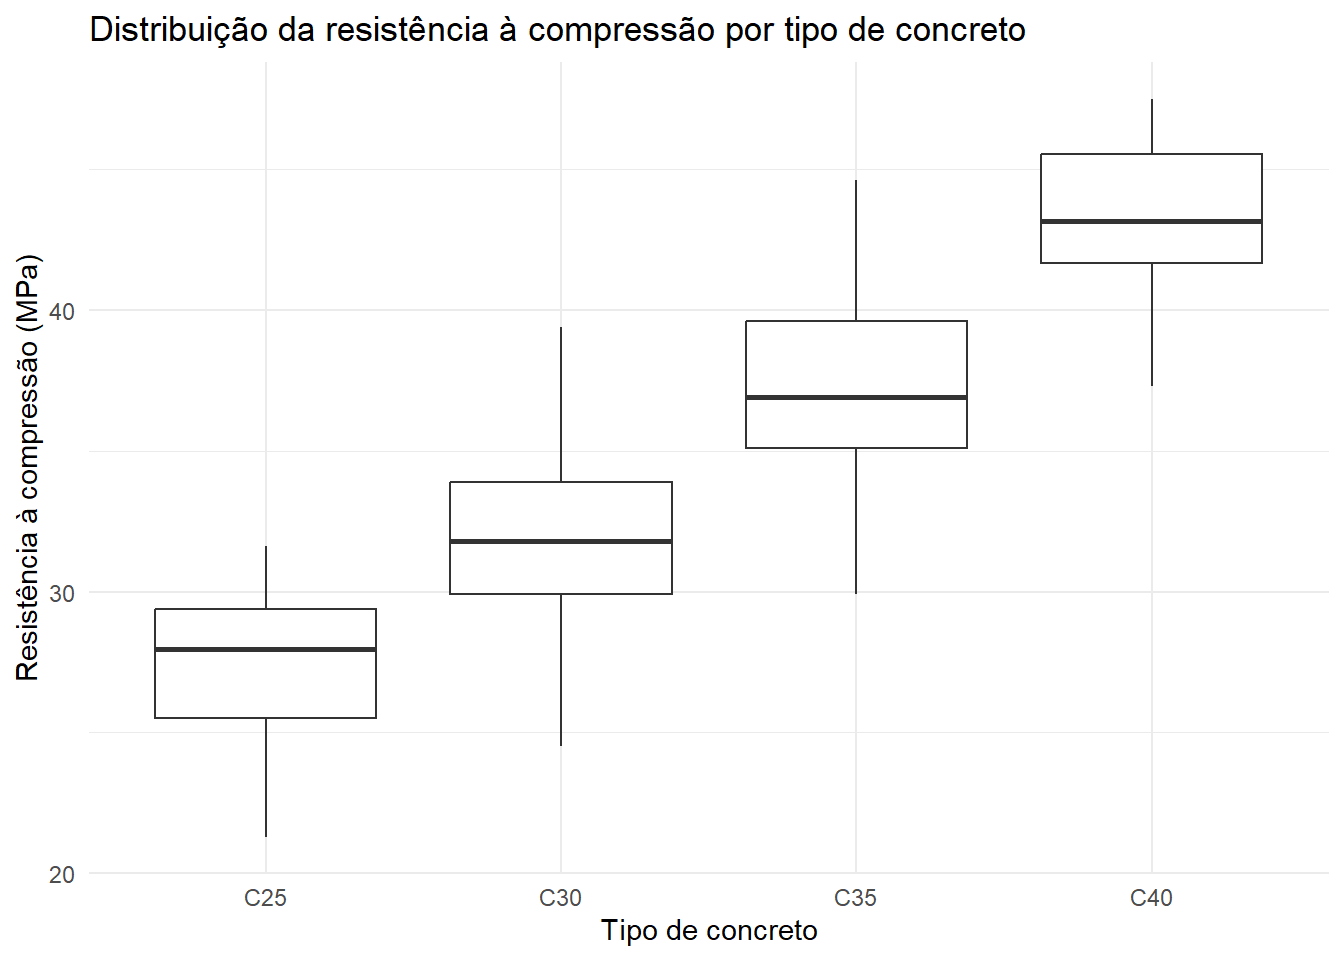
A partir do gráfico, observa-se um aumento progressivo dos valores de resistência à compressão conforme aumenta a classe do concreto. A classe C25 apresenta os menores valores, seguida pelas classes C30, C35 e C40. Além disso, as medianas acompanham essa tendência crescente, indicando que concretos de classes superiores apresentam, de forma geral, maiores resistências. A dispersão dos resultados apresenta variações entre as classes, sendo possível avaliar pelo boxplot a amplitude e a concentração dos valores em cada grupo.
Para investigar a relação entre o consumo de cimento e a resistência à compressão do concreto, foi elaborado um gráfico de dispersão. Cada ponto representa uma observação da base de dados, enquanto a linha de tendência permite visualizar o comportamento geral da relação entre as variáveis.
ggplot(
dados_limpos,
aes(
x = cimento_kg_m3,
y = resistencia_mpa
)
) +
geom_point() +
geom_smooth(
method = "lm",
se = FALSE
) +
labs(
title = "Relação entre consumo de cimento e resistência à compressão",
x = "Consumo de cimento (kg/m³)",
y = "Resistência à compressão (MPa)"
) +
theme_minimal()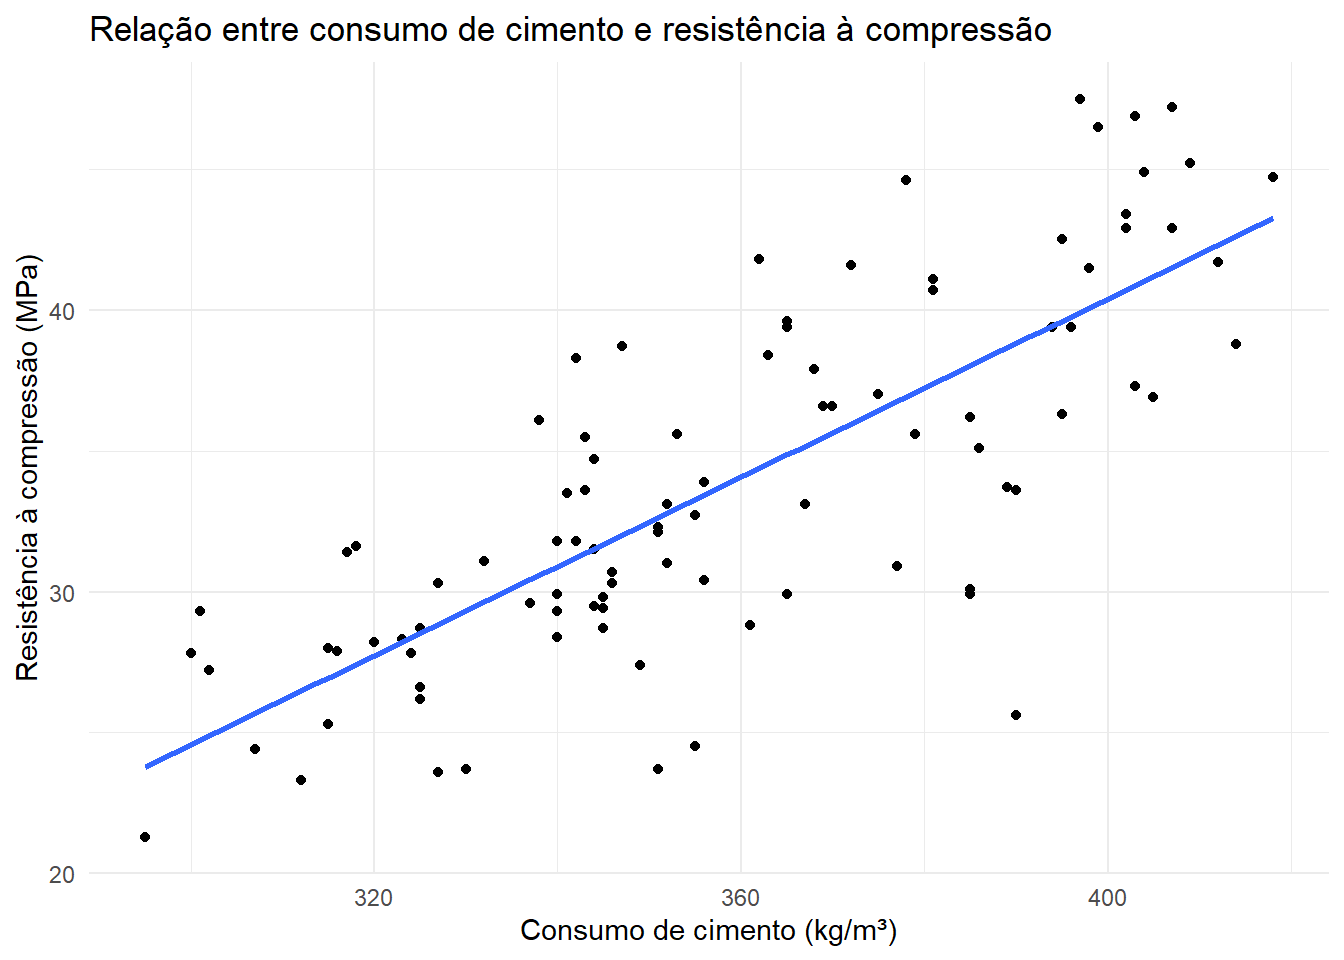
A partir do gráfico, observa-se uma tendência crescente entre o consumo de cimento e a resistência à compressão, indicando que maiores consumos de cimento estão, de forma geral, associados a maiores valores de resistência. A inclinação positiva da linha de tendência fornece evidência visual compatível com a afirmação de que, à medida que aumenta o consumo de cimento, a resistência do concreto tende a aumentar. No entanto, os pontos não se encontram perfeitamente alinhados, indicando que a resistência também pode ser influenciada por outras características da mistura, além do consumo de cimento.
Para investigar a relação entre a relação água/cimento e a resistência à compressão, foi elaborado um gráfico de dispersão. Também foi adicionada uma linha de tendência linear para facilitar a identificação do comportamento geral entre as duas variáveis.
ggplot(
dados_limpos,
aes(
x = relacao_a_c,
y = resistencia_mpa
)
) +
geom_point() +
geom_smooth(
method = "lm",
se = FALSE
) +
labs(
title = "Relação entre água/cimento e resistência à compressão",
x = "Relação água/cimento",
y = "Resistência à compressão (MPa)"
) +
theme_minimal()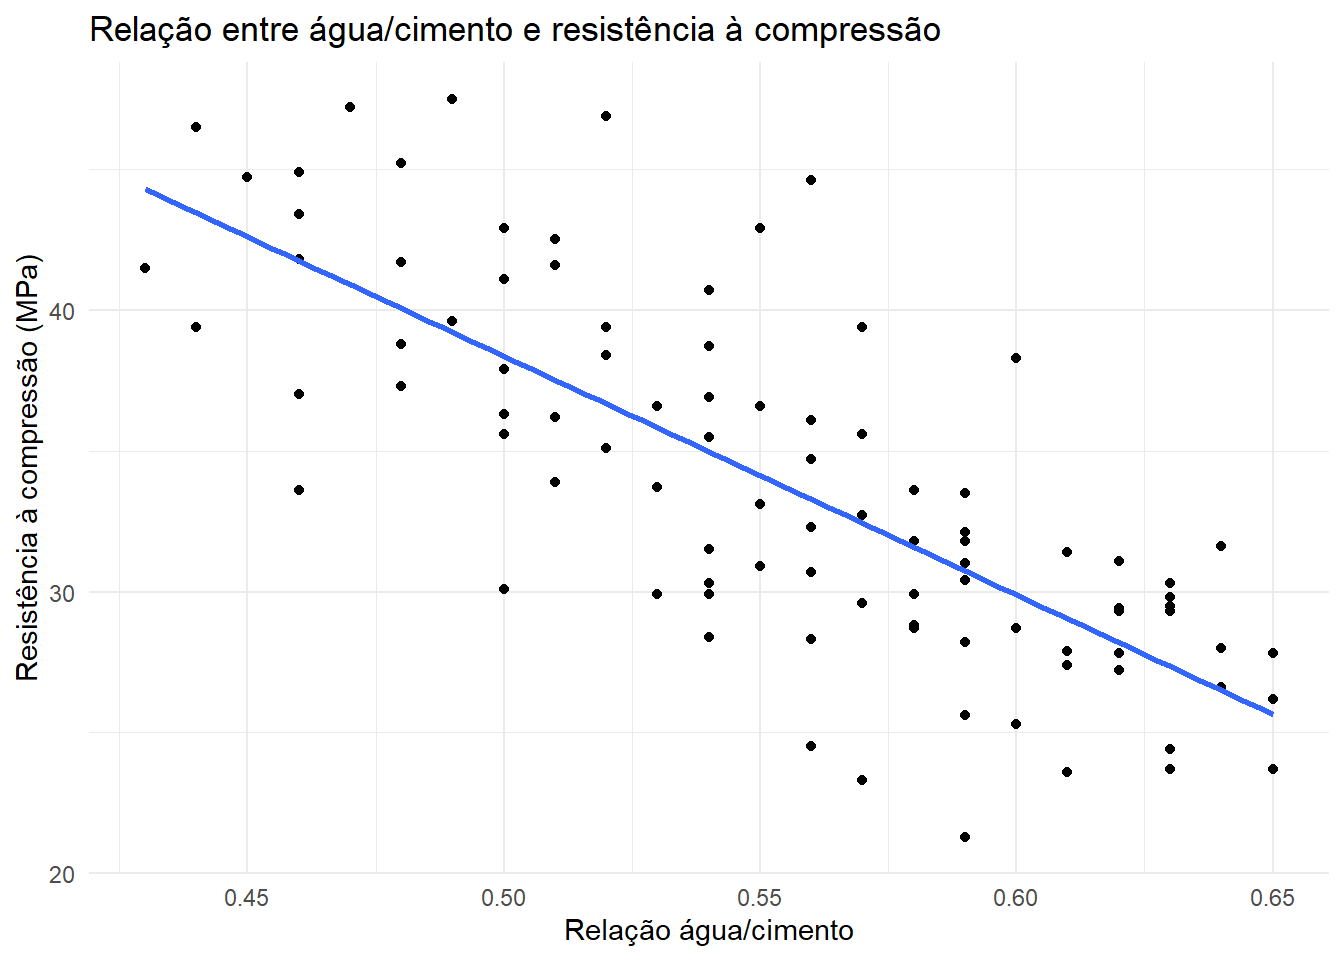
A partir do gráfico, observa-se uma tendência decrescente entre a relação água/cimento e a resistência à compressão, indicando que menores valores da relação a/c tendem a estar associados a maiores valores de resistência. A inclinação negativa da linha de tendência reforça visualmente esse comportamento. Entretanto, verifica-se dispersão dos pontos ao redor da linha, indicando que a resistência não depende exclusivamente da relação água/cimento.
Após as etapas de inspeção, tratamento e exploração da base de dados, as informações obtidas podem ser utilizadas na análise de situações mais próximas da prática profissional da Engenharia Civil. Nesta etapa, busca-se interpretar os dados do controle tecnológico do concreto e verificar se eles fornecem suporte a determinadas afirmações relacionadas ao desempenho dos materiais empregados na obra.
Uma das questões levantadas refere-se ao desempenho dos concretos utilizados nos diferentes blocos da obra, mais especificamente à afirmação de que os concretos empregados no Bloco C apresentam desempenho superior aos utilizados nos demais blocos.
Para realizar uma primeira avaliação dessa afirmação, será calculada a resistência média à compressão dos corpos de prova de cada bloco.
resumo_obras <- dados_limpos |>
group_by(obra) |>
summarise(
resistencia_media = mean(resistencia_mpa),
.groups = "drop"
) |>
arrange(desc(resistencia_media))
resumo_obras |>
knitr::kable(
caption = "Resistência média à compressão por bloco da obra",
col.names = c(
"Bloco",
"Resistência média (MPa)"
),
digits = 2
)| Bloco | Resistência média (MPa) |
|---|---|
| Bloco B | 35.68 |
| Bloco A | 33.43 |
| Bloco D | 33.35 |
| Bloco C | 32.62 |
ggplot(
resumo_obras,
aes(
x = obra,
y = resistencia_media
)
) +
geom_col() +
labs(
title = "Resistência média à compressão por bloco",
x = "Bloco da obra",
y = "Resistência média (MPa)"
) +
theme_minimal()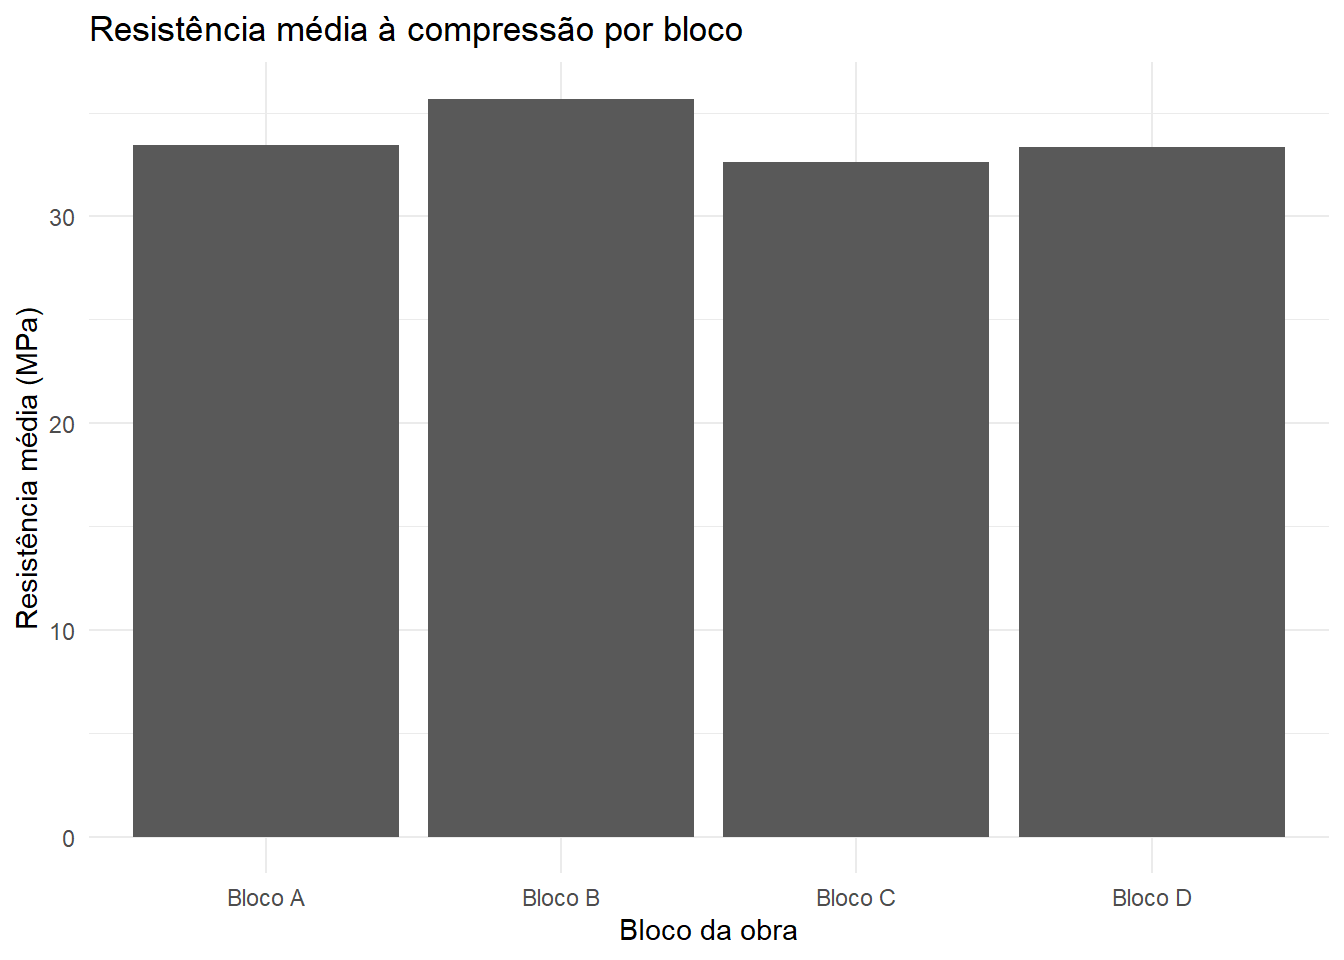
Entretanto, como a base apresenta diferentes classes de concreto, a análise também será realizada considerando separadamente cada tipo de concreto, evitando que diferenças na composição dos grupos influenciem diretamente a comparação entre os blocos.
resumo_obra_concreto <- dados_limpos |>
group_by(obra, tipo_concreto) |>
summarise(
resistencia_media = mean(resistencia_mpa),
.groups = "drop"
)
resumo_obra_concreto |>
knitr::kable(
caption = "Resistência média por bloco e tipo de concreto",
col.names = c(
"Bloco",
"Tipo de concreto",
"Resistência média (MPa)"
),
digits = 2
)| Bloco | Tipo de concreto | Resistência média (MPa) |
|---|---|---|
| Bloco A | C25 | 28.28 |
| Bloco A | C30 | 30.53 |
| Bloco A | C35 | 35.78 |
| Bloco A | C40 | 42.58 |
| Bloco B | C25 | 27.82 |
| Bloco B | C30 | 33.24 |
| Bloco B | C35 | 38.48 |
| Bloco B | C40 | 42.00 |
| Bloco C | C25 | 27.03 |
| Bloco C | C30 | 32.02 |
| Bloco C | C35 | 35.10 |
| Bloco C | C40 | 44.98 |
| Bloco D | C25 | 26.15 |
| Bloco D | C30 | 32.28 |
| Bloco D | C35 | 37.00 |
| Bloco D | C40 | 44.95 |
ggplot(
resumo_obra_concreto,
aes(
x = tipo_concreto,
y = resistencia_media,
group = obra,
linetype = obra
)
) +
geom_line() +
geom_point() +
labs(
title = "Resistência média por tipo de concreto e bloco",
x = "Tipo de concreto",
y = "Resistência média (MPa)",
linetype = "Bloco"
) +
theme_minimal()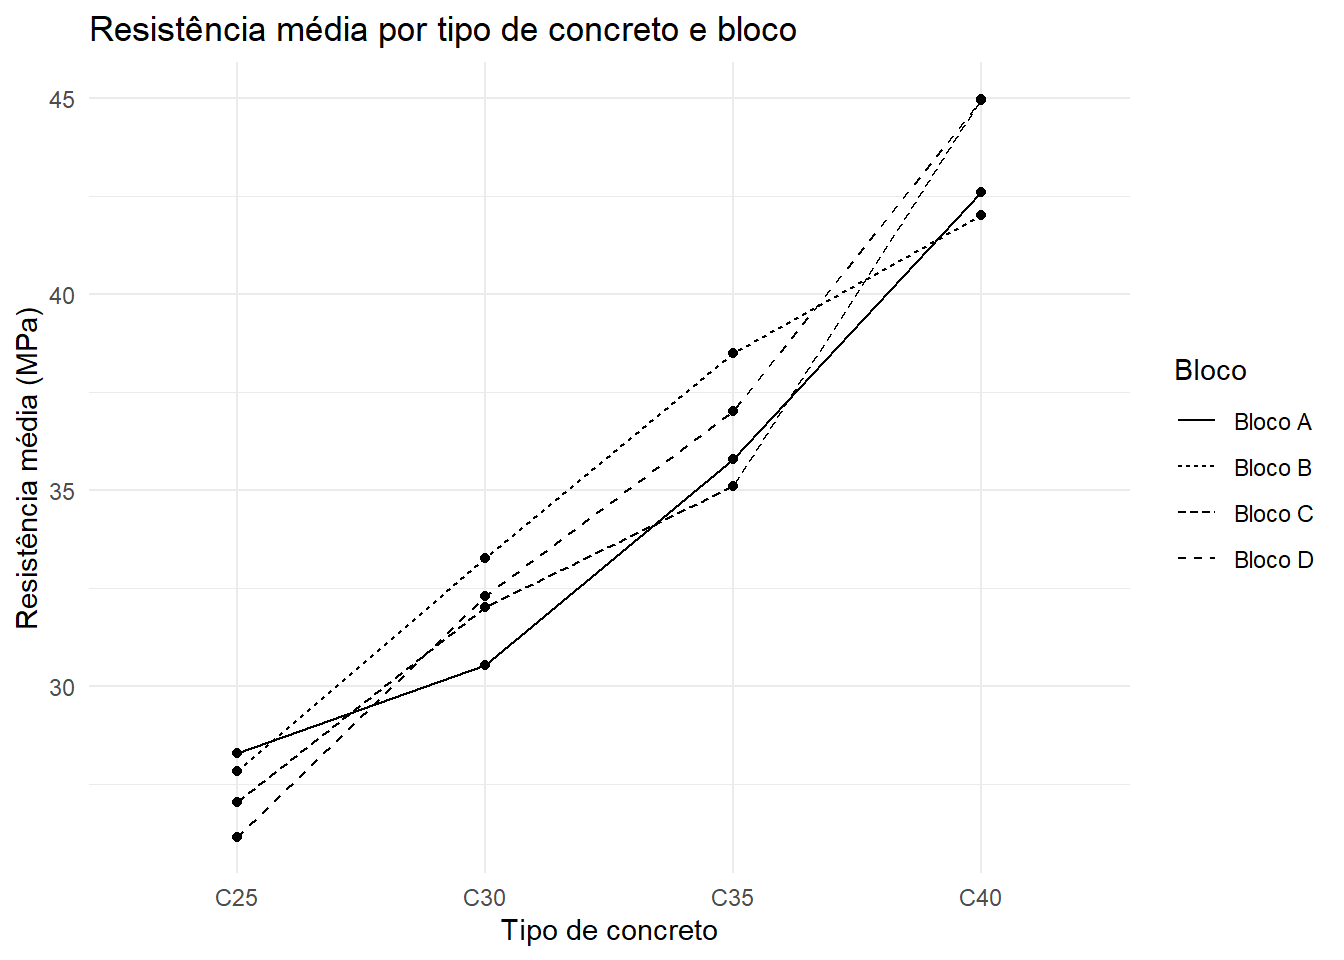
A comparação inicial entre os blocos mostra que o Bloco C não apresenta a maior resistência média à compressão. Sua média geral foi de 32,62 MPa, sendo a menor entre os quatro blocos analisados. O Bloco B apresentou a maior média, com aproximadamente 35,68 MPa, enquanto os Blocos A e D apresentaram valores intermediários.
Entretanto, como os blocos apresentam diferentes proporções de classes de concreto, também foi realizada uma comparação considerando separadamente os tipos de concreto, de forma a detalhar melhor a distribuição das médias por resistência dentro de cada bloco.
Considerando os resultados obtidos, não há suporte descritivo suficiente para afirmar que os concretos utilizados no Bloco C apresentam desempenho superior aos utilizados nos demais blocos. A superioridade do Bloco C é observada apenas para o concreto C40.
A idade do corpo de prova também é uma variável relevante na avaliação da resistência do concreto, uma vez que o material tende a desenvolver resistência ao longo do tempo em função da continuidade das reações de hidratação do cimento.
Para verificar esse comportamento na base analisada, será calculada a resistência média à compressão para cada idade dos corpos de prova. A comparação entre esses valores permitirá identificar se existe uma tendência de aumento da resistência com o avanço da idade.
media_por_idade <- dados_limpos |>
group_by(idade_dias) |>
summarise(
resistencia_media = mean(resistencia_mpa),
.groups = "drop"
) |>
arrange(idade_dias)
media_por_idade |>
knitr::kable(
caption = "Resistência média à compressão por idade",
col.names = c(
"Idade (dias)",
"Resistência média (MPa)"
),
digits = 2
)| Idade (dias) | Resistência média (MPa) |
|---|---|
| 7 | 28.78 |
| 14 | 35.83 |
| 28 | 34.96 |
| 56 | 33.12 |
ggplot(
media_por_idade,
aes(
x = idade_dias,
y = resistencia_media
)
) +
geom_line() +
geom_point() +
labs(
title = "Resistência média à compressão em função da idade",
x = "Idade (dias)",
y = "Resistência média (MPa)"
) +
theme_minimal()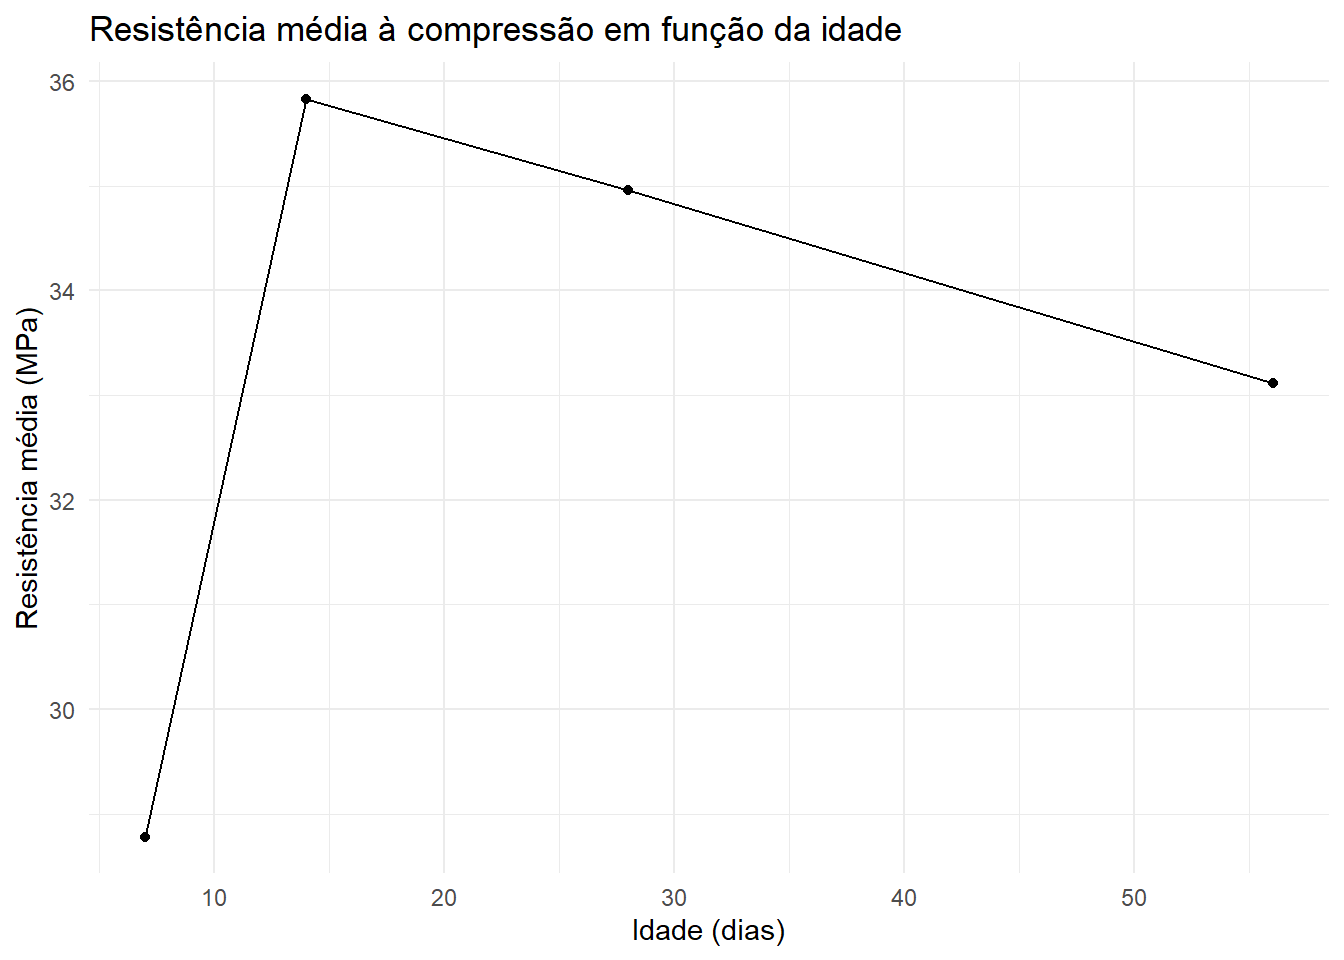
Observa-se um aumento expressivo da resistência média entre 7 e 14 dias, passando de aproximadamente 28,78 MPa para 35,83 MPa. Entretanto, nas idades seguintes ocorre uma pequena redução, com médias de 34,96 MPa aos 28 dias e 33,12 MPa aos 56 dias.
Dessa forma, considerando apenas as médias gerais por idade, os dados não apresentam um crescimento contínuo da resistência ao longo do tempo. Porém, avaliando este resultado de forma técnica, deve-se levar em consideração que as classes de concreto existentes na base de dados podem estar distribuídas de forma diferente entre as idades analisadas.
Portanto, a seguir, serão apresentados os comportamentos de resistência ao longo do tempo considerando as diferentes classes de concreto.
media_idade_concreto <- dados_limpos |>
group_by(tipo_concreto, idade_dias) |>
summarise(
resistencia_media = mean(resistencia_mpa),
.groups = "drop"
) |>
arrange(tipo_concreto, idade_dias)
media_idade_concreto |>
knitr::kable(
caption = "Resistência média por idade e tipo de concreto",
col.names = c(
"Tipo de concreto",
"Idade (dias)",
"Resistência média (MPa)"
),
digits = 2
)| Tipo de concreto | Idade (dias) | Resistência média (MPa) |
|---|---|---|
| C25 | 7 | 25.26 |
| C25 | 14 | 28.30 |
| C25 | 28 | 28.12 |
| C25 | 56 | 27.30 |
| C30 | 7 | 28.96 |
| C30 | 14 | 30.87 |
| C30 | 28 | 33.30 |
| C30 | 56 | 33.88 |
| C35 | 7 | 30.00 |
| C35 | 14 | 35.92 |
| C35 | 28 | 37.89 |
| C35 | 56 | 42.85 |
| C40 | 7 | 42.50 |
| C40 | 14 | 41.33 |
| C40 | 28 | 44.14 |
ggplot(
media_idade_concreto,
aes(
x = idade_dias,
y = resistencia_media,
group = tipo_concreto,
linetype = tipo_concreto
)
) +
geom_line() +
geom_point() +
labs(
title = "Resistência média por idade e tipo de concreto",
x = "Idade (dias)",
y = "Resistência média (MPa)",
linetype = "Tipo de concreto"
) +
theme_minimal()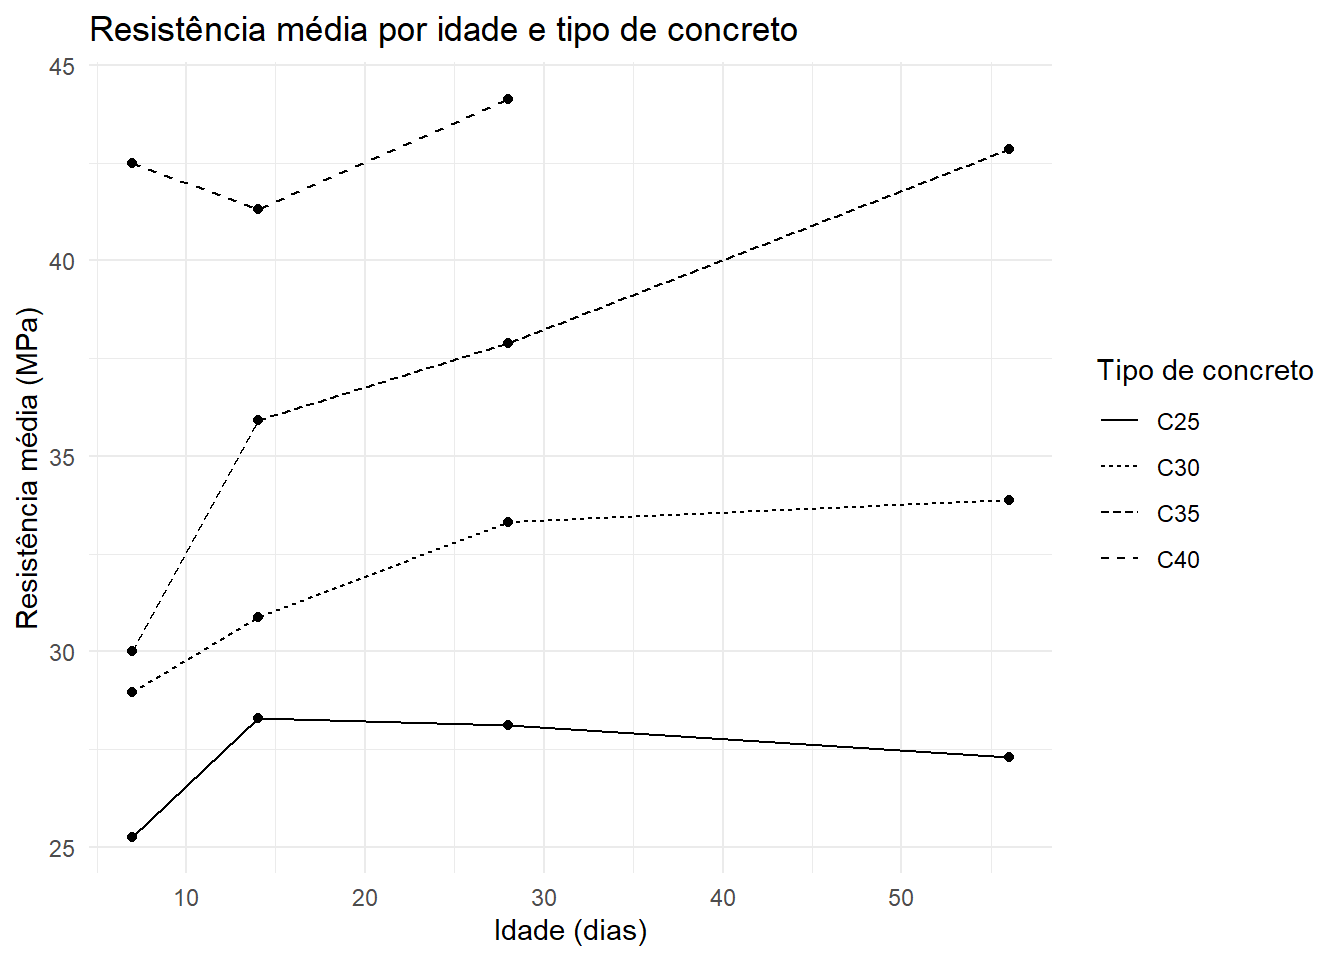
Ao analisar os resultados separadamente para cada tipo de concreto, o comportamento fica mais evidente. Para os concretos C30 e C35, observa-se um aumento da resistência média conforme a idade avança. No concreto C25, ocorre um aumento inicial até os 14 dias, seguido de pequenas variações. Já o C40 apresenta uma pequena redução aos 14 dias e volta a aumentar aos 28 dias, não havendo resultados aos 56 dias.
Dessa forma, a análise por classe de concreto representa melhor o comportamento dos dados, pois evita que as diferenças de resistência existentes entre C25, C30, C35 e C40 interfiram na comparação entre as idades. De modo geral, observa-se uma tendência de ganho de resistência com o avanço da idade, embora esse comportamento não ocorra de maneira uniforme em todas as classes.
Para a elaboração da tabela-resumo, foram selecionadas informações que permitem avaliar o comportamento geral da resistência dos concretos, a variabilidade dos resultados e a ocorrência de valores abaixo da referência.
A quantidade de ensaios informa o número de corpos de prova avaliados em cada classe. A média e a mediana permitem analisar o comportamento central dos resultados, enquanto o desvio-padrão indica o grau de dispersão e a uniformidade dos valores obtidos.
A resistência mínima observada permite identificar o menor resultado registrado em cada classe. Já o percentual de ensaios que atingiram a resistência mínima estabelecida mostra qual parcela dos corpos de prova alcançou o valor mínimo esperado para sua respectiva classe.
tabela_resumo <- dados_limpos |>
group_by(tipo_concreto) |>
summarise(
quantidade = n(),
resistencia_media = mean(resistencia_mpa),
mediana = median(resistencia_mpa),
desvio_padrao = sd(resistencia_mpa),
resistencia_minima = min(resistencia_mpa),
percentual_atende = mean(
classificacao == "Atende ou supera a referência"
) * 100,
.groups = "drop"
)
tabela_resumo |>
knitr::kable(
caption = "Resumo estatístico para acompanhamento da qualidade do concreto",
col.names = c(
"Tipo de concreto",
"N",
"Média (MPa)",
"Mediana (MPa)",
"Desvio-padrão (MPa)",
"Resistência mínima observada (MPa)",
"Ensaios que atingiram a resistência mínima (%)"
),
digits = 2
)| Tipo de concreto | N | Média (MPa) | Mediana (MPa) | Desvio-padrão (MPa) | Resistência mínima observada (MPa) | Ensaios que atingiram a resistência mínima (%) |
|---|---|---|---|---|---|---|
| C25 | 26 | 27.45 | 27.95 | 2.77 | 21.3 | 76.92 |
| C30 | 32 | 32.08 | 31.80 | 3.57 | 24.5 | 71.88 |
| C35 | 21 | 37.14 | 36.90 | 3.77 | 29.9 | 76.19 |
| C40 | 16 | 43.33 | 43.15 | 3.08 | 37.3 | 81.25 |
Como etapa final, busca-se reunir em um único script os principais procedimentos realizados ao longo da análise da base de dados. O processamento contempla a importação e inspeção inicial dos dados, identificação e tratamento de valores ausentes e inconsistências, criação de novas variáveis, obtenção de estatísticas descritivas e elaboração de representações gráficas.
# DESAFIO FINAL - PROCESSAMENTO E ANÁLISE DOS DADOS
library(tidyverse)
# 1. IMPORTAÇÃO E INSPEÇÃO DOS DADOS
# Importação da base de dados
dados <- read_delim(
"base_processamento_dados_engenharia_civil.csv",
delim = ";",
locale = locale(decimal_mark = "."),
show_col_types = FALSE
)
# Inspeção da estrutura da base
dados |>
glimpse()
# Verificação das dimensões da base
dados |>
summarise(
observacoes = n(),
variaveis = ncol(dados)
)
# Identificação dos tipos das variáveis
dados |>
summarise(
across(
everything(),
~ class(.x)
)
) |>
pivot_longer(
cols = everything(),
names_to = "Variável",
values_to = "Tipo reconhecido pelo R"
)
# 2. IDENTIFICAÇÃO DE PROBLEMAS E VALORES AUSENTES
# Contagem dos valores ausentes por variável
dados |>
summarise(
across(
everything(),
~ sum(is.na(.x))
)
) |>
pivot_longer(
cols = everything(),
names_to = "Variável",
values_to = "Valores ausentes"
)
# Localização das observações com valores ausentes
registros_ausentes <- dados |>
mutate(
possui_na = if_any(
everything(),
is.na
)
) |>
filter(possui_na) |>
select(-possui_na)
registros_ausentes
# Definição das variáveis quantitativas reconhecidas como texto
variaveis_quantitativas_texto <- c(
"resistencia_mpa",
"cimento_kg_m3",
"relacao_a_c"
)
# Identificação de inconsistências nas variáveis quantitativas
problemas_identificados <- dados |>
select(
id_corpo_prova,
all_of(variaveis_quantitativas_texto)
) |>
pivot_longer(
cols = all_of(variaveis_quantitativas_texto),
names_to = "Variável",
values_to = "Valor"
) |>
mutate(
valor_teste = parse_double(Valor)
) |>
filter(
!is.na(Valor) & is.na(valor_teste)
) |>
select(
id_corpo_prova,
Variável,
Valor
)
problemas_identificados
# Verificação das categorias da variável obra
dados |>
count(obra)
# Verificação das categorias da variável tipo_concreto
dados |>
count(tipo_concreto)
# 3. LIMPEZA E TRATAMENTO DOS DADOS
# Criação de uma cópia da base original
dados_limpos <- dados
# Remoção das observações com valores ausentes
dados_limpos <- dados_limpos |>
drop_na()
# Correção das inconsistências de formatação e digitação
dados_limpos <- dados_limpos |>
mutate(
resistencia_mpa = resistencia_mpa |>
str_replace_all(",", ".") |>
str_replace("3O.4", "30.4"),
relacao_a_c = relacao_a_c |>
str_replace_all(",", "."),
cimento_kg_m3 = cimento_kg_m3 |>
str_replace("390O", "390")
)
# Conversão das variáveis quantitativas para formato numérico
dados_limpos <- dados_limpos |>
mutate(
resistencia_mpa = parse_double(resistencia_mpa),
cimento_kg_m3 = parse_double(cimento_kg_m3),
relacao_a_c = parse_double(relacao_a_c)
)
# Investigação estatística dos valores após a primeira correção
dados_limpos |>
  summary()
# Correção dos valores numéricos inconsistentes
dados_limpos <- dados_limpos |>
mutate(
idade_dias = if_else(
id_corpo_prova == "CP-085", 28, idade_dias
),
abatimento_mm = if_else(
id_corpo_prova == "CP-032", 125, abatimento_mm
),
densidade_kg_m3 = if_else(
id_corpo_prova == "CP-053", 2380, densidade_kg_m3
),
absorção_agregado_pct = if_else(
id_corpo_prova == "CP-072", 1.84, absorção_agregado_pct
)
)
# Padronização das variáveis qualitativas
dados_limpos <- dados_limpos |>
mutate(
obra = str_trim(obra),
tipo_concreto = str_to_upper(tipo_concreto)
)
# 4. CRIAÇÃO DE VARIÁVEIS DERIVADAS
# Criação da resistência relativa
dados_limpos <- dados_limpos |>
mutate(
resistencia_referencia = case_when(
tipo_concreto == "C25" ~ 25,
tipo_concreto == "C30" ~ 30,
tipo_concreto == "C35" ~ 35,
tipo_concreto == "C40" ~ 40
),
resistencia_relativa =
resistencia_mpa / resistencia_referencia
)
# Remoção da variável auxiliar de resistência de referência
dados_limpos <- dados_limpos |>
select(-resistencia_referencia)
# Classificação dos resultados em relação à resistência de referência
dados_limpos <- dados_limpos |>
mutate(
classificacao = case_when(
resistencia_relativa < 1 ~ "Abaixo da referência",
resistencia_relativa >= 1 ~ "Atende ou supera a referência"
)
)
# Identificação dos resultados acima da média da própria classe
dados_limpos <- dados_limpos |>
group_by(tipo_concreto) |>
mutate(
acima_media = resistencia_mpa > mean(resistencia_mpa)
) |>
ungroup()
# 5. ESTATÍSTICAS DESCRITIVAS
# Estatísticas da resistência por tipo de concreto
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
quantidade = n(),
media = mean(resistencia_mpa),
mediana = median(resistencia_mpa),
desvio_padrao = sd(resistencia_mpa),
minimo = min(resistencia_mpa),
maximo = max(resistencia_mpa)
)
# Cálculo das médias das propriedades por tipo de concreto
medias_tipo_concreto <- dados_limpos |>
group_by(tipo_concreto) |>
summarise(
across(
c(
resistencia_mpa,
cimento_kg_m3,
relacao_a_c,
abatimento_mm,
densidade_kg_m3
),
mean
),
.groups = "drop"
)
medias_tipo_concreto
# Cálculo da resistência média por idade e tipo de concreto
media_idade_concreto <- dados_limpos |>
group_by(
tipo_concreto,
idade_dias
) |>
summarise(
resistencia_media = mean(resistencia_mpa),
.groups = "drop"
) |>
arrange(
tipo_concreto,
idade_dias
)
media_idade_concreto
# 6. REPRESENTAÇÕES GRÁFICAS
# Gráfico da relação entre consumo de cimento e resistência
ggplot(
  dados_limpos,
  aes(
    x = cimento_kg_m3,
    y = resistencia_mpa
  )
) +
  geom_point() +
  geom_smooth(
    method = "lm",
    se = FALSE
  ) +
  labs(
    title = "Relação entre consumo de cimento e resistência à compressão",
    x = "Consumo de cimento (kg/m³)",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
# Gráfico da relação entre água/cimento e resistência
ggplot(
  dados_limpos,
  aes(
    x = relacao_a_c,
    y = resistencia_mpa
  )
) +
  geom_point() +
  geom_smooth(
    method = "lm",
    se = FALSE
  ) +
  labs(
    title = "Relação entre água/cimento e resistência à compressão",
    x = "Relação água/cimento",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
# 7. INFORMAÇÕES PARA O ENGENHEIRO RESPONSÁVEL
# Construção da tabela-resumo para acompanhamento da qualidade
tabela_resumo <- dados_limpos |>
group_by(tipo_concreto) |>
summarise(
quantidade = n(),
resistencia_media = mean(resistencia_mpa),
mediana = median(resistencia_mpa),
desvio_padrao = sd(resistencia_mpa),
resistencia_minima = min(resistencia_mpa),
percentual_atende = mean(
classificacao == "Atende ou supera a referência"
) * 100,
.groups = "drop"
)
# Apresentação da tabela final
tabela_resumo |>
knitr::kable(
caption = "Resumo estatístico para acompanhamento da qualidade do concreto",
col.names = c(
"Tipo de concreto",
"N",
"Média (MPa)",
"Mediana (MPa)",
"Desvio-padrão (MPa)",
"Resistência mínima observada (MPa)",
"Ensaios que atingiram a resistência mínima (%)"
),
digits = 2
)A principal diferença entre a utilização da Base R e das ferramentas da família tidyverse está na forma de organizar o processamento dos dados. No tidyverse, funções como filter(), select(), mutate(), group_by() e summarise(), associadas ao operador |>, permitem construir uma sequência de etapas mais padronizada e de fácil leitura. Além disso, funções como across() reduzem a repetição de comandos ao permitir a aplicação de uma mesma operação a diferentes variáveis.
O processamento e a limpeza dos dados são fundamentais antes da aplicação de métodos estatísticos, pois inconsistências podem alterar médias, medidas de dispersão, gráficos e, consequentemente, a interpretação dos resultados. Na Engenharia Civil, trabalhar com uma base corretamente estruturada contribui para que as análises representem de forma mais confiável a situação estudada.
O principal problema encontrado na base foi a presença de diferentes inconsistências, incluindo valores ausentes, erros de digitação e formatação, variáveis quantitativas reconhecidas como texto e categorias sem padronização. Para o tratamento, foram removidas as cinco observações com valores ausentes e corrigidos os demais problemas identificados. Foram utilizadas funções como drop_na(), mutate(), if_else(), str_replace(), parse_double(), str_trim() e str_to_upper(), além de funções empregadas na investigação, como filter(), summarise() e across().
A solução foi considerada adequada porque os problemas foram identificados antes das alterações e tratados de acordo com cada tipo de inconsistência, mantendo-se também uma cópia da base original. Após o processamento, obteve-se uma base com 95 observações completas, variáveis quantitativas em formato numérico e categorias padronizadas, adequada para a realização das análises estatísticas propostas.
A realização da atividade permitiu aplicar as ferramentas do tidyverse em diferentes etapas do processamento de uma base de dados, desde sua organização e tratamento até a obtenção de estatísticas e representações gráficas. A partir dessas ferramentas, foi desenvolvida a organização e a exploração das diferentes informações presentes na base.
Em relação aos dados analisados, os resultados permitiram observar diferenças de resistência entre as classes de concreto, além das relações existentes com características como idade, consumo de cimento e relação água/cimento. Também foi possível verificar que a análise apenas de valores médios nem sempre é suficiente, sendo necessário considerar a distribuição e a variabilidade dos resultados.
Dessa forma, foi possível associar as ferramentas de processamento de dados à interpretação técnica dos resultados aplicados à Engenharia Civil, nas quais as informações obtidas podem contribuir para a avaliação e o acompanhamento do comportamento dos materiais.
ASSOCIAÇÃO BRASILEIRA DE NORMAS TÉCNICAS. ABNT NBR 8953:2015: concreto para fins estruturais - classificação pela massa específica, por grupos de resistência e consistência. Rio de Janeiro: ABNT, 2015. ISMAY, Chester; KIM, Albert Y.; VALDIVIA, Arturo. Statistical inference via data science: a ModernDive into R and the Tidyverse. 2. ed., 2026. Disponível em: https://moderndive.com/v2/.